Sora 2 世界狀態解析|為什麼它能讓多鏡頭影片保持一致
sora2 是什麼
sora2 是 OpenAI 推出的一款文生影片 AI 應用,目前僅以 Android APK 形式發布(版本 1.2026.050,安裝包約 23.05MB)。它的核心能力是透過文字提示詞或參考圖片,在數秒到數十秒內生成具備物理可信度的影片片段——不同於早期模型只能輸出孤立的單鏡頭片段,sora2 引入了持續運轉的「世界狀態」機制,讓多鏡頭場景能保持人物外貌、光照方向與場景邏輯的一致性,適合需要快速產出影片概念驗證、創作短鏡頭故事或探索 AI 生成可能性的創作者與愛好者——想了解更詳細的操作指南,可參考這份 sora2 的下載安裝與使用指南。
安裝
sora2 目前以 Android APK 形式發布,安裝與首次啟動需注意以下幾點:
- 平台前置:需 Android 10 及以上版本,設備需提前開啟「未知來源」安裝權限(路徑:設定 → 安全性 → 允許安裝未知應用);
- 數據包下載:首次啟動時,應用會自動下載約 1.2GB 的核心模型數據包(這是世界模擬器運行的基礎資產,建議在 Wi-Fi 環境下進行),若下載中斷,應用會自動續傳,無需手動重裝;
- 帳號與額度:首次使用需綁定 OpenAI 帳號,新用戶可獲得 500 次免費生成額度(對應 10 秒 480P 影片),超額使用需付費升級;
- 權限要求:應用需授予相機(用於參考圖上傳)、儲存空間(用於生成影片導出)與網路權限,若拒絕權限,應用不會崩潰,但部分功能(如參考圖生圖、影片導出)會受限。若需要更詳細的安裝步驟說明,可參考 sora2下載 的完整安裝教程。
世界狀態:從單鏡頭到多鏡頭的轉折點
作為一個從事 AI 應用研究的開發者,我最初對 sora2 最感興趣的不是它能生成多麼華麗的畫面,而是它解決了一個早期文生影片模型長期存在的頑疾:跨鏡頭一致性。
早期模型的痛點:沒有持續的世界記憶
假設你用 Runway Gen-2 生成兩段影片,都是同一個人在同一片沙灘上:
- 鏡頭 1:穿紅色救生衣的男人從左邊跑到右邊;
- 鏡頭 2:同一個男人彎腰撿貝殼。
在 2024 年的模型裡,這兩個鏡頭裡的「男人」大概率長得完全不同——臉型、頭髮、衣服細節都會變,甚至沙灘的光照都可能從陰天變成晴天。原因很簡單:每一段影片都是獨立生成的,模型沒有一個持續運轉的世界狀態來記住「之前發生了什麼」。
這就像你讓畫家畫兩幅畫,卻不告訴他第一幅畫裡有什麼元素,他只會根據當下的靈感創作,兩幅畫的風格、人物、場景自然無法對齊。
Sora 2 的解法:世界模擬器架構
sora2 的核心設計是引入了「世界模擬器」架構——模型內部有一個持續運轉的世界狀態,當你連續生成多個鏡頭時,這個狀態會一直記住:
- 那個紅衣服男人長什麼樣;
- 現在是下午幾點,光照從哪個方向來;
- 沙灘上之前有什麼物體(貝殼、岩石);
- 甚至人物的重心、衣物的材質反光等物理細節。
第二個鏡頭生成時,模型會先讀取這個持續的世界狀態,再生成新的畫面。這就像畫家畫第二幅畫時,先把第一幅畫放在旁邊當參考,確保兩幅畫的元素一致。
這種設計的效果是顯著的:評測者發現,sora2 的跨鏡頭人物外貌穩定、服裝細節不會突然變化、光照與氛圍一致、位置關係合理。這意味著你可以用它來講一個多鏡頭的小故事,而不是只能生成零散的片段——這是從「工具」到「創作夥伴」的質變。
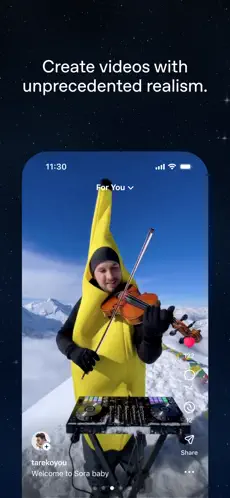
上圖是 OpenAI 在 sora2 發布時展示的宣傳畫面——穿香蕉服的小提琴手站在雪山上拉琴。這個荒誕的元素組合被模型處理得相當真實,光照、陰影、人物姿態、雪面質感都沒有明顯破綻,這正是世界狀態內化了物理規律的直接體現。
Remix 設計:把世界狀態變成社區驅動力
sora2 的另一個巧妙設計是 Remix 功能——你可以基於別人的作品,只改一句提示詞就生成一個新版本。這背後的原理同樣是世界狀態:Remix 不是從零開始生成,而是在原版影片的世界狀態上做增量修改,所以新影片能保持原版的風格、光照與場景邏輯。
從交互設計來看,Remix 把 AI 生成的「不確定性」變成了社區的「驅動力」:
- 系統用綠色高亮標註你改了哪些字,讓原版創作者也能看到你的修改;
- 每個 Remix 都鏈接到它的父版本,社區裡形成了一條條創作鏈,而不是一堆孤立的影片;
- 好的 Remix 會反過來帶動原版的傳播,讓社區內容變成一張互相連接的網。
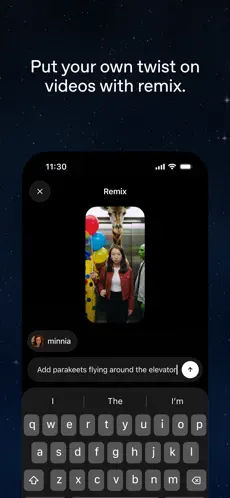
上圖的 Remix 界面展示了一個直觀的例子:原版可能是一個安靜的電梯場景,用戶只把提示詞改成「給電梯四周加一群飛舞的長尾鸚鵡」,就能生成一個全新的版本——這種低門檻的二創設計,把 AI 生成的可能性交給了社區。
設計取捨:世界狀態的代價與邊界
當然,沒有免費的午餐。sora2 的世界模擬器架構也有明顯的代價與邊界:
- 資源消耗:模型更重(安裝包 23MB + 首次下載 1.2GB 核心數據包),生成時間比早期模型長(一個 10 秒片段可能需要 1-2 分鐘);
- 多鏡頭天花板:片段數量超過 5 個時,一致性會開始退化——模型能保持畫面一致,但不能幫你編故事,長敘事仍然依賴大量人工調優;
- 寫實邊界:在極致寫實場景(真實人臉、真實手部)下,模型仍然會露出破綻;但在電影感、動漫/風格化場景下表現很好——這是因為風格化內容對物理細節的容錯率更高,世界狀態的優勢更能發揮;
- 水印的困境:OpenAI 為了防偽造,嵌入了移動水印與 C2PA 元數據雙重溯源機制,但發布後七天就被輕鬆繞過——這暴露了一個行業共識:生成式影片的溯源不能只靠技術方案,需要平台側強制標記、監管側明確法律要求、用戶側媒介素養教育的多方面配合。
適用場景與未來
綜合來看,sora2 的世界狀態架構意味著它更適合以下場景:
- 需要多鏡頭一致性的影片概念驗證(比如 3-5 個鏡頭的短故事);
- 電影感、動漫/風格化內容的快速產出;
- 社區驅動的二創(Remix 鏈式創作)。
而不適合的場景包括:極致寫實的真實人像生成、超長敘事的完整影片製作、需要強溯源的新聞類內容。
sora2 最大的意義不在於它能生成多麼華麗的畫面,而在於它把「從零開始做一個像樣的多鏡頭概念驗證」的門檻從幾周降到了幾小時——這是 AI 生成內容從「玩具」變成「創作夥伴」的關鍵一步。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。