把 LongCat 嵌进每周任务链:从资料整理到输出一次打通
LongCat 是什么
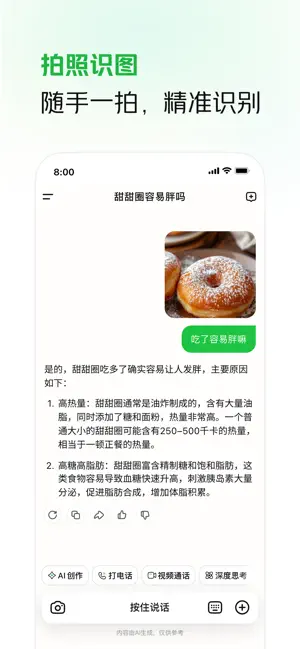
LongCat 是美团旗下的多模态 AI 助手,2025 年 11 月上线后保持两到六周一次的更新节奏,目前已经覆盖文字对话、语音通话、联网搜索、深度思考、文生图、图片理解、视频通话等能力。它的技术底层用了创新的捷径连接专家混合架构,可以在 18.6 亿到 31.3 亿参数规模之间动态调度,平均约 27 亿参数——在手机端这个量级的模型能维持比较快的响应速度,不会让你对着转圈等半天。
对我来说,它最核心的价值不是某一个功能点有多强,而是「联网搜索 + 深度思考 + 多模态输入」这三件事凑齐了之后,可以替代掉我之前分散在三四个工具里的资料收集和初步分析工作。素材来源不固定的时候(比如临时要查某个行业的最新进展、某个活动的具体规则),它比直接问模型靠谱,因为会实时读网页,给的回答附带来源标注;需要深度推理的时候(比如逻辑题、复杂写作结构),开深度思考模式能给出带步骤的推演,而不是顺口溜式的答案。
安装
LongCat下载 目前只有 Android APK 版本,大小约 94.69M,安装包本身不算小,但下载和安装过程比较顺畅。最省心的点是账号体系——它直接复用美团账号,登录只要手机号 + 短信验证码,没有美团账号的话首次验证会自动帮你创建,不需要单独注册一套账号密码。多设备(手机 App 和网页版)共用同一个账号,对话记录云端同步,换设备登录历史会话还在。
安装完第一次打开,界面很干净,底部就是对话输入框,首页会有一些功能引导提示。建议先更新到最新版本再开始用——版本演进速度快,像多张图片生成、深度思考支持多级思考、定位回答位置相关问题这些功能都是 2026 年陆续加上的,旧版本可能缺少你需要的能力。如果 App 内有 OTA 更新入口直接点就行,没有的话去应用商店搜索更新。
旧流程:每周任务链的断点
我每周要做的事情大致是:收集行业动态(3~5 个来源的最新资讯)→ 整理成一份结构化摘要 → 标记需要进一步跟进的点。以前这条链长这样:
- 打开 3~5 个资讯源的网页,手动翻一遍,把值得留的文章标题和链接复制到一个临时笔记里——这个动作每次要花 15~20 分钟,而且经常漏;
- 分别打开每篇文章,用浏览器的"阅读模式"或复制粘贴到笔记里,再手动提炼出"核心观点、数据、引用来源"三个要素——这一步是最卡的,单篇 3000 字的文章我提炼至少要 8~10 分钟;
- 把所有提炼内容合并成一份周报,自己重新组织语言,标注信息来源,有时候还要补充一些交叉验证(比如两个来源的数据冲突时去查第三个)——合并和重写又是 20 分钟。
整条链跑下来要一个多小时,而且每个环节都容易断:网页打不开、内容太长没耐心读完、复制粘贴格式乱掉、交叉验证的时候找不到可靠的第三方来源。最烦的是最后发现某篇文章其实不是最新的,白整理了。
新流程:LongCat 做中枢
现在这条链我改成了 LongCat 做中枢,上下游配合的工具只有两个:一个笔记软件(存最终输出),一个文件分享渠道(需要的时候把周报转同事)。
第一步:批量收集 + 初步筛选
我会把本周要跟进的几个主题(比如"短视频平台新政策""AI 行业融资事件")一次性发给 LongCat,开联网搜索。通常的提问方式是这样的:
"帮我查一下本周短视频平台有什么新政策出台,重点关注抖音、快手、视频号,把结果整理成结构化摘要,每条包含:标题、发布时间、来源、核心内容(3 句话以内)。如果有互相冲突的说法,把冲突的点列出来。"
它会并行抓 10 个左右的网页,每读一个就在回答顶部加一行"已阅读 N 个网页"的提示,回答里的关键结论带角标数字,对应它读过的来源。我不用一个个翻网页了,直接拿它整理好的摘要,扫一眼就能判断哪些值得跟进、哪些可以跳过——这一步从 20 分钟缩到了 5 分钟以内。
第二步:深度思考做结构化提炼
对筛选出来的 3~5 篇值得深挖的文章,我把网页链接或关键段落的文字复制给 LongCat,开深度思考模式,让它帮我做结构化提炼。具体指令:
"对这篇文章做结构化提炼,按下面的格式输出:
- 核心论点(一句话)
- 关键数据(如果有的话,逐条列出来)
- 作者的推理逻辑(步骤化,不要跳步)
- 可能存在的漏洞或需要验证的点"
深度思考模式会先复述题意、标出已知条件、选择解法并说明为什么选它、逐步推演——这个过程比我自己读文章提炼要靠谱得多。LongCat 背后模型的形式化推理能力在这类任务上有专门优化,让它自己列约束再推理,正确率明显提升。
第三步:合并 + 补充交叉验证
等 3~5 篇的提炼结果都出来,我把它们拼在一起,让 LongCat 帮我做交叉验证:
"把这几条信息合并成一份周报。对于不同来源之间的数据或说法冲突的地方,标注出来并建议我进一步查什么。周报要结构清晰,每个条目包含:主题、核心发现、来源标注、备注(交叉验证状态)。"
合并和重写这一步现在基本不用我自己动手了,LongCat 会自动做信息整合、去重、标注冲突点,最后输出一份结构清晰的周报。
实操细节:最容易断链的两个环节
这条链跑了几周之后,我发现两个环节最容易断,专门说一下怎么处理。
环节一:联网回答里的来源标注怎么用
回答顶部的"已阅读 N 个网页"这一行字,是整个联网功能里最值得学会看的东西。它表示为了回答你的问题,模型实时检索并阅读了 N 个网页——不是凭记忆,是现读的,记忆可能过时,现读不会。回答里的关键结论旁会带小标注(角标数字),对应它读过的来源:
- 想核实某个说法,顺着标注找到对应来源;
- 想深挖细节,优先去看原始页面而不是继续追问;
- 两个来源打架时,回答通常会并列呈现,让你自己判断。
阅读数量上,3~5 个网页是常规事实查询够用,10 个上下是对比、综述类问题覆盖面更广。重要决策(比如健康、法律、消费大额支出)的时候,我会把联网回答当"导读"而不是"结论"——读它给的总结,再点开最相关的两三个原始来源自己确认。工具给的是效率,判断留给自己。
环节二:深度思考的触发条件和指令写法
不是所有问题都需要开深度思考。常规事实查询直接联网搜索就行,逻辑推理、复杂写作结构、多步骤拆解这些场景才需要。开了深度思考之后,指令写法也有讲究——加一句"先列出所有约束再推理,最后自检一遍",逻辑题的正确率会明显提升。
还有个实用技巧:让它出题而不是只答题。比如做某个知识点的整理时,我会说"按这个知识点出 5 道难度递进的题,我先做你后批"——它当陪练比当答案机更省时间。批改的时候让它"逐段点评,指出具体句子的问题",比笼统打分有用得多。
效果与边界
跑下来这条链省了不少事——原来 60~70 分钟的周报工作,现在 20~30 分钟搞定,少了两次手动复制、少了一次跨三个工具的切换、少了三次因为网页打不开或内容太长而中途放弃的经历。
但也不是所有场景都划算。LongCat 每周更新一次,功能迭代快,但深度思考对竞赛级难题、需要最新考纲的题目可能出错,需要交叉验证别的来源;直接抄 AI 答案应付作业没有学习价值,让它在"讲思路"模式下工作更划算;教材版本差异可能导致解法风格不同,确认不了就以官方最新版为准。还有一点——深度思考比普通回答慢不少,简单问题别乱开,浪费时间。
这套流程的核心思路是把 LongCat 当"信息中枢"用,让它帮你从多个来源收集、初步筛选、结构化提炼、交叉验证,而不是替你做判断。判断永远留给自己,工具负责把你从机械重复里解放出来。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。