我把 LibLibAI 嵌进了内容生产流水线:从单张出图到批量工作流
LibLibAI 是什么
LibLibAI官网(哩布哩布AI)是一款把「模型社区」和「在线 AI 生成平台」装在一起的中文创作工具。运营主体是北京奇点星宇科技,2023 年成立后围绕 Stable Diffusion 生态搭起国内最大的模型分享社区之一,后来逐步接入 FLUX、混元、可灵、Seedance 等更多基础模型。它和普通生图 App 的核心区别在于:风格不靠长提示词硬凹——风格问题交给模型解决。同一个提示词配上写实人像底模和二次元动漫底模,产出天差地别,所以站内最核心的动作是「选模型」而非「写提示词」。
作为 Android APK 发布的同时也提供 Web 版和桌面客户端,平台上能做的事远不止文生图:图生图、局部重绘、超分放大、在线跑 ComfyUI 工作流、LoRA 训练、接入视频模型生成片段——几乎覆盖了 AI 图像创作从原始素材到成品出链的全链路。
安装
LibLibAI下载 以 Android APK 形式分发,最新版本 2.1.4,安装包大小 60.15M,包名 com.liblib.app。安装本身没有特殊前置条件,常规允许未知来源即可。但有一个差异化的点:首次启动时需要确认你是直接用云端生成还是下载本地模型——这决定了后续工作流的跑法。云端生成零安装开销、手机即可操作但走积分;本地模型下载后可离线跑但对设备性能有要求。
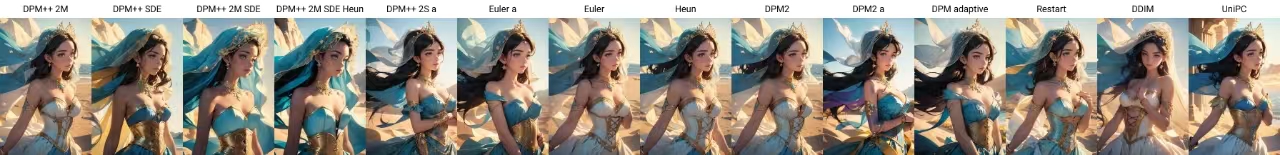
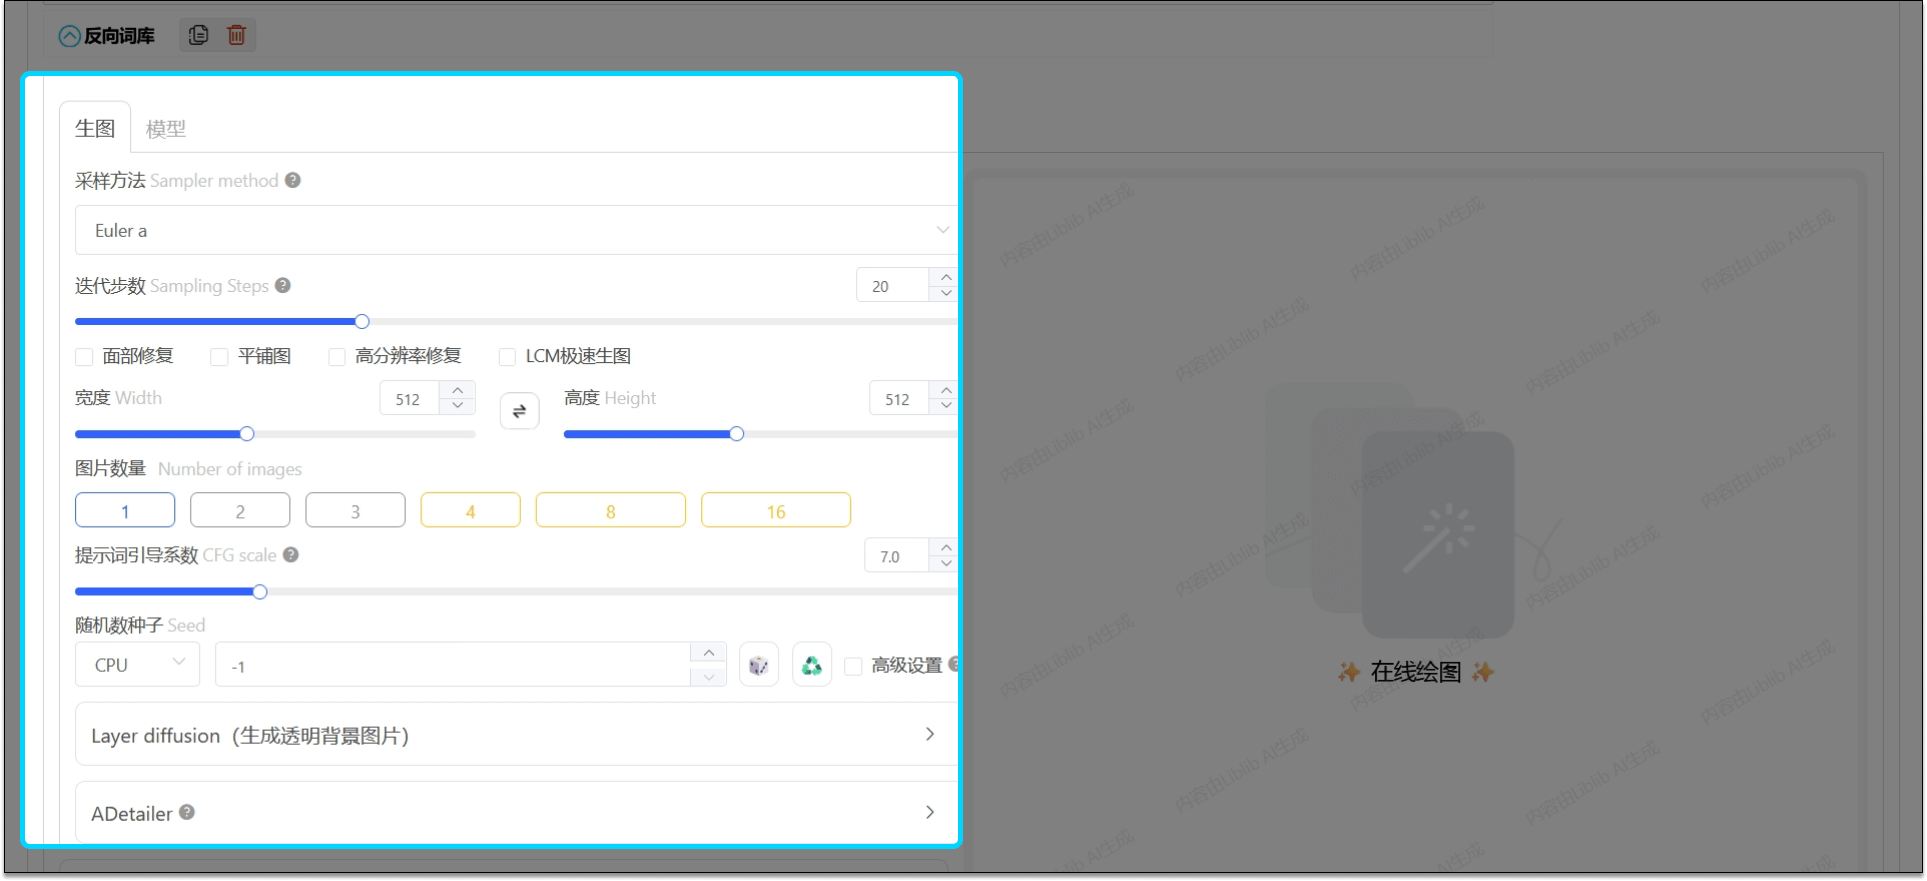
建议同时装 APK + 桌面客户端 + 收藏 Web 版。三者各有用途:APK 在路上临时改图或拍素材当参考图;桌面客户端跑批量任务和 LoRA 训练;Web 版在浏览器里直接调用 ComfyUI 工作流、不占本地资源。安装完第一件事不是立刻生图,而是把默认采样器设成 DPM++ 2M Karras + 20 步,这是社区默认率最高的泛用基线配置,先有基线再对比才知道换模型到底带来了多少提升。
旧流程的痛点
在把 LibLibAI 嵌进我的内容流水线之前,每周社媒配图的流程是这样的:
- 翻模型社区找 LoRA 或底模,一个个下载到本地——不同模型分布在不同站,还得手动整理目录
- 打开 WebUI,手动加载模型、写提示词、开生成
- 出图后发现手脚崩坏,手动挂 ADetailer 插件重新跑一遍
- 图糊了,开超分放大插件再等一轮
- 把成品图从本地拷到网盘,然后把网盘链接贴进发稿脚本里
一套流程下来至少半小时,中间每一步都可能断链——模型找不到版本号存不存在、插件忘了开、放大完忘了导出、网盘链接过期要重新转存。最糟的时候出图环节排队半小时(当时还是免费用户),排完队发现参数写错得重来,等于一小时没了。
把 LibLibAI 插进工作流的哪一环
现在这套流程压缩到了五分钟,核心就是把 LibLibAI 放在了「模型选择 → 生图 → 修图 → 存储」的中心位置,周围只保留三个衔接点:
上游:模型选择环节——过去我要翻 Civitai、Hugging Face 找模型下载,现在直接在 LibLibAI 的模型库搜索,看中哪个点一下就挂到在线 WebUI 里。社区模型自带作者标注的触发词和推荐参数,不用自己去 README 里扒。如果看中的图有现成的工作流,直接点开参数页整套抄过来(采样器、步数、CFG 一个不差),比盲试快得多。
中间:生图 + 修图合并环节——这是 LibLibAI 整合能力最体现效率的地方。以前生图、ADetailer 修手、超分放大是三个独立步骤,现在在在线 ComfyUI 里一键串成一条工作流:底模加载 → 提示词编码 → 采样生成 → ADetailer 自动检测并修复手脚 → R-ESRGAN 超分 → 导出成品。社区已经有人把这条工作流传上来了,搜「人像批量出图」就能找到,直接导入在线运行。
下游:存储与分发环节——LibLibAI 会员档带 30GB~300GB 云端存储,生成的图自动归档。我在发稿脚本里加了一个钩子:图生成完后从云端复制直链(会员存储支持直接外链),自动贴进飞书文档的配图槽位,少了两次手动复制。
最容易断链的两个环节
环节一:参数抄作业时漏了种子
复制别人出图参数时最容易漏的就是「种子」字段。LibLibAI 支持把整套参数(模型、提示词、采样器、步数、CFG、种子)一起打包导出 PNG 内嵌信息,对方点开参数页时就能看到全部。我把这个习惯固化了:每次觉得效果好的图,都导出一份 PNG info 文件存到本地素材库,下次想复现直接拖进参数编辑器,不会因为漏种子导致出图风格漂移。
环节二:并发排队时误提交重复任务
会员档位从入门版到高级版并发数从 3 个涨到 20 个,我用的进阶版 12 并发跑批量很顺,但免费用户高峰期排队是常态。排队时最容易犯的错是看进度条慢就重复点提交——LibLibAI 会按任务 ID 去重,重复提交的任务会被自动合并,但如果是不同提示词改了几个字就点两次,等于白扣两次积分。生图界面右侧有实时的并行任务进度(比如 0/3),排队时忍一会儿,别重复点。
另外,如果任务失败白扣了积分,先去积分明细页核对任务 ID 再找客服,别直接开骂——站内规则是任务 ID 对上才好沟通,空口说「失败了扣我积分」客服根本没法查。
效果与边界
这套流程跑了三个月,量化下来:
- 单篇社媒配图从半小时压缩到五分钟
- 因为参数漏填、插件忘开导致的返工率从 40% 降到 5% 以下
- 存储环节从手动拷网盘改成自动归档,少了两次手动复制
但这套流程不是万能的。以下情况我还是会回到本地跑:
- 需要商用级高清大图(2048×2048 以上)时,云端超分的算力成本不如本地 4090
- 训练自定义 LoRA 时,上传素材 + 在线训练的积分消耗比本地显卡训练贵得多
- 需要完全离线运行(比如涉密素材或网络环境不稳定时)
还有一点必须说清楚:风格问题交给模型解决,但模型选择本身需要积累。LibLibAI 的模型库里同一主题可能有上百个底模,光看名字分不出好坏。我自己的做法是每周抽半小时在「作品灵感」页随机刷 50 张图,看到效果好的就记住作者用的模型名——这个动作积累下来,对"什么底模适合什么场景"的直觉会越来越准,比盯着参数面板死磕高效得多。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。