Hay 全球即時視訊聊天的幕後架構拆解
Hay 是什麼
Hay官網 是一款主打全球隨機視訊聊天的社交應用,由北京海聊科技開發,最新版本 8.60.1,安裝包約 147MB。與 Tinder、Bumble 這種先配資料再聊天的模式不同,Hay 讓你一鍵進入全球視訊配對池——接通的對象可能來自東南亞、歐洲、美洲任何一個時區,接通後自動開啟即時翻譯,你說中文對方看到的是他母語文字,反之亦然。
這款應用最有辨識度的三個能力疊在一起:全球配對、即時翻譯、端側美顏。單看每個都不是新東西,但三者同時跑在一次視訊通話裡,而且要維持低延遲——這背後的架構取捨,比表面上的「隨機聊天」四個字要複雜得多。
安裝
Hay下載 目前主打安卓平台(APK 安裝包),版本迭代很快,本站整理時的參考版本為 8.53.0,你拿到的版本可能更新或更舊。安裝前建議做三件事:查包名、查體積、查權限——官方國際版包名為 com.soud.hai,中文版包名是 cn.hay.android,兩者差在語言與調度節點。如果安裝來源標註的包名對不上,直接換渠道。
安裝包大小約 147MB,同版本體積差異超過 20MB 的要警惕。安裝過程會請求相機、麥克風、位置三個核心權限——這三個是視訊配對的硬需求,拒絕任何一個都會導致匹配環節卡住或接通即黑屏。如果應用還索要不相干的全量通訊錄、簡讀權限,果斷拒絕並換來源。
首次啟動時有兩個必做動作:一是註冊帳號(支持手機號或第三方登入),二是進入設定頁把語言偏好、地區過濾這些基本項設好——這些會影響後續配對池的命中率。舊版本殘留可能導致匹配服務拒接,安裝前乾淨卸載一次比升級覆蓋更穩。
全球配對:為什麼隨機匹配能撐起百萬同時在線
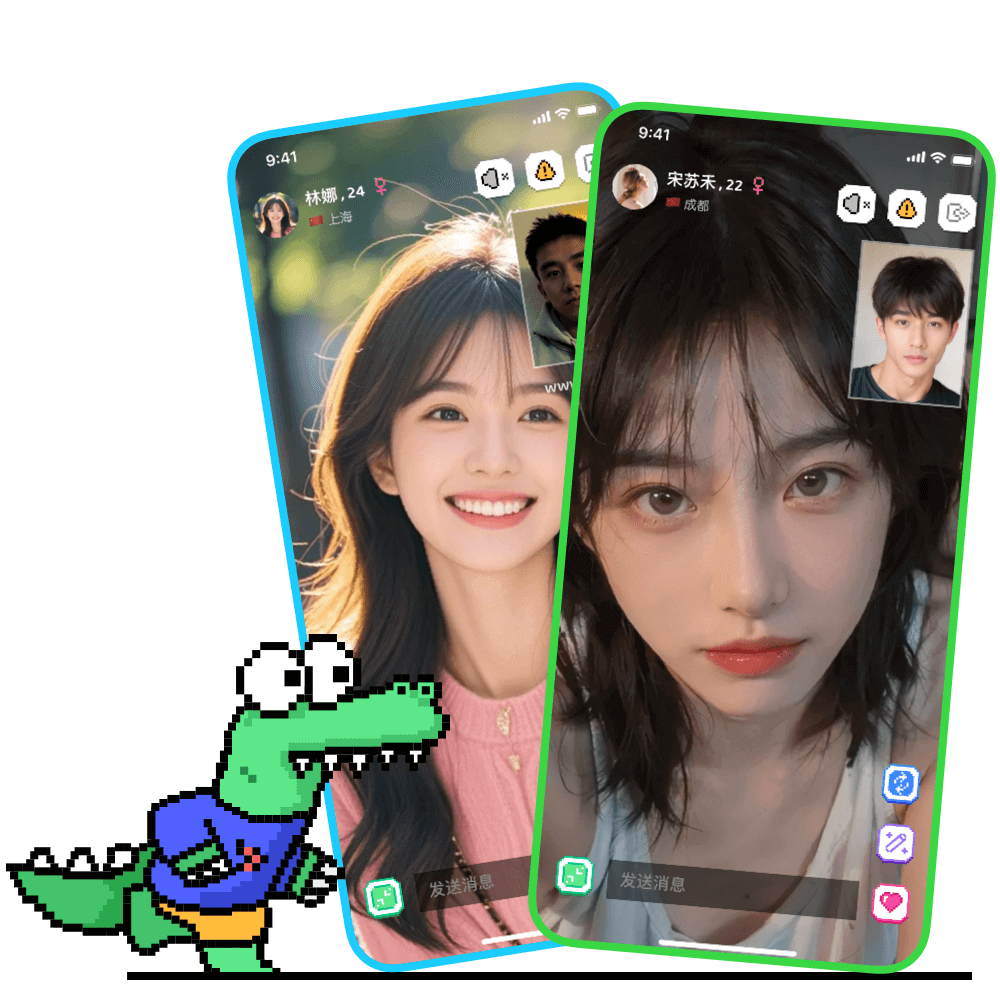
我在測試 Hay 的時候第一個好奇是:它怎麼做到「按一個按鈕,三秒鐘接通地球另一端的人」?這看起來簡單,但全球視訊配對要解決三個難題——用戶池分片、低延遲路由、以及「條件收窄時配對失敗」的概率控制。
用戶池的地理分片架構
Hay 把全球在線用戶按地理位置切進多個配對池——不是一個大池子裡亂撈,而是每個區域有獨立的調度節點。當你點「開始匹配」時,請求先打到離你最近的邊緣節點,然後節點根據你的地區偏好、性別過濾、興趣標籤這些條件,去對應的分片裡查閒置用戶。這個設計的好處是查詢範圍被限制在一個可控的集合裡,不會因為全球百萬在線而讓一次匹配查詢變成數十毫秒以上。
但分片有個副作用:如果你把條件疊得太窄(性別 × 地區 × 興趣全選),而你所在的分片裡符合條件的用戶本來就少,匹配等待時間就會拉長甚至超時。這也是為什麼官方建議「第一次先用全隨機跑」——全隨機時節點只需要查一個分片裡的所有人,命中率是最高的。
低延遲路由:為什麼視訊通話的聲音畫面能同步
視訊通話的延遲來源有兩段:信號進入前的握手和傳輸中的擁塞。Hay 在握手階段用的是 WebRTC 的 ICE(Interactive Connectivity Establishment)協定——簡單說就是應用先嘗試所有可能的網路路徑(P2P 直接連、STUN 穿透 NAT、TURN 中繼轉發),找到延遲最低的一條,然後把這條路徑的候選名單傳給對方。雙方同時收到候選名單後,最快的那條路徑就被選定了。
如果雙方 NAT 無法穿透(比如一方在嚴格的公司網路後面),就退化到 TURN 中繼——所有流量經由 Hay 的中繼伺服器轉發,延遲會從 100ms 以下拉到 300~500ms。你在弱網下遇到的畫面卡頓、聲音延遲,大部分就是這個退化機制在起作用。
配對失敗的概率控制
應用內統計顯示,工作日白天的匹配等待時間平均是晚間高峰的 3~5 倍——這不是系統慢,而是在線用戶基數本身就少。Hay 不會為了維持匹配速度而隨機推薦,它的調度器有一個硬閾值:當候選池裡符合條件的用戶低於某個數量時,匹配請求會自動擴大搜索半徑(比如從「同國家」放寬到「同大洲」),而不是一直卡著轉圈。
即時翻譯:為什麼不是單純在字幕條上跑 Google Translate
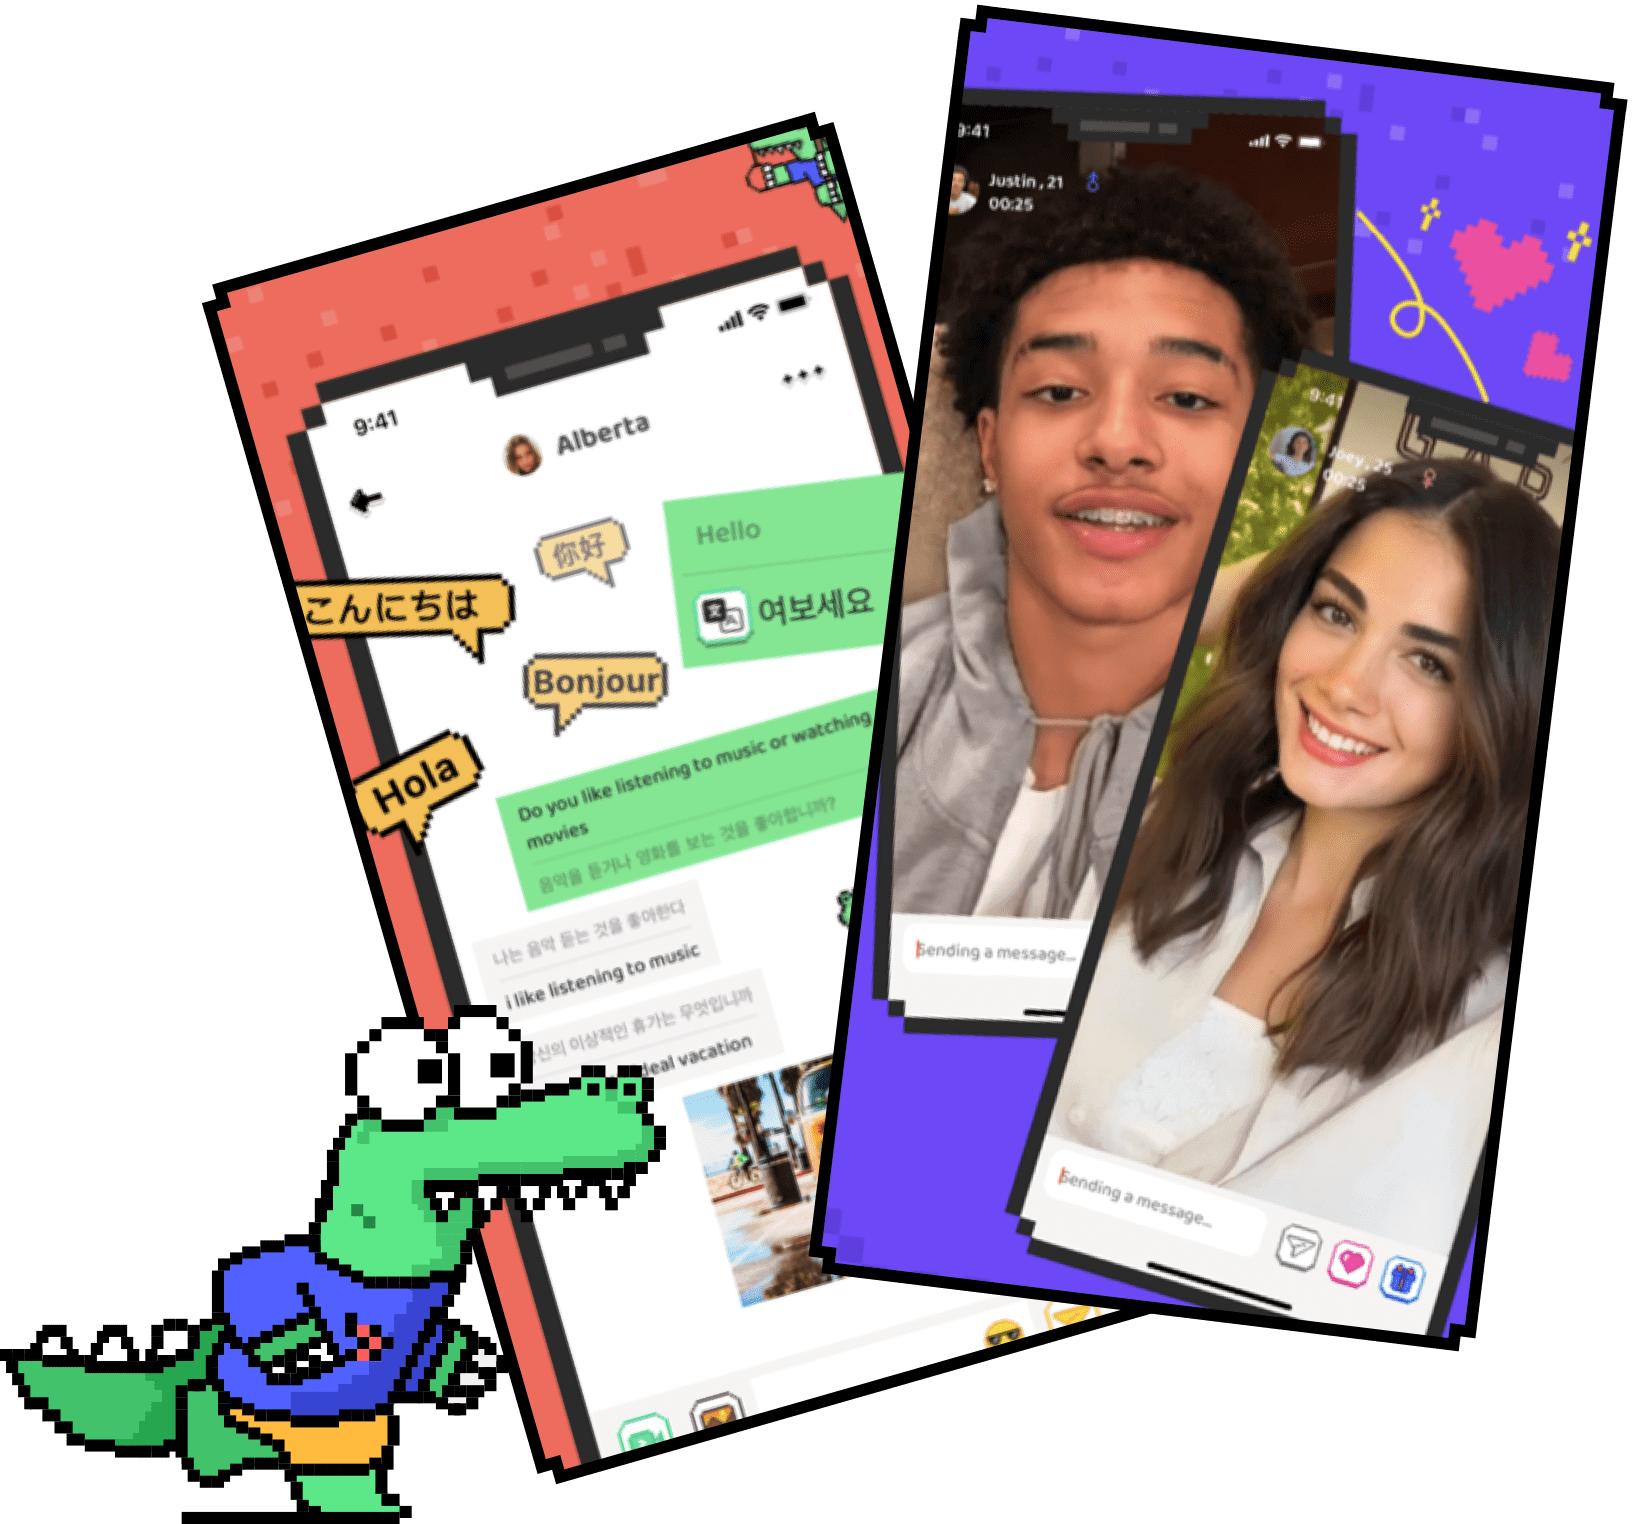
這是 Hay 最有意思的技術取捨。多數視訊聊天應用要做跨語言溝通,最直觀的做法就是在畫面下方加一條字幕條——但 Hay 選擇了一個更激進的設計:翻譯結果直接進入對方的文字流,對方看到的不是帶翻譯字幕的視訊畫面,而是翻譯後的純文字消息,他可以選擇用文字回覆或繼續開口說話。
旁路架構:翻譯與 RTC 流的解耦
要理解這個設計,先回憶一下視訊通話的核心——RTC(即時通訊)流。這條流承載的是音頻和視訊的壓縮幀,對延遲極端敏感:任何處理都必須在 100ms 內完成,否則畫面和聲音就會失步。Hay 沒有把翻譯掛在 RTC 流上,而是開了一條獨立的語音識別旁路:
- 說話方的音頻同時送到兩個地方——RTC 編碼器(給對方聽原聲)和 ASR(自動語音識別)服務
- ASR 把音頻轉成文字,文字送到翻譯服務
- 翻譯結果通過另一條資料通道推給對方
- 對方的介面同時顯示「原聲音訊 + 翻譯文字」
這樣做的好處是翻譯延遲不會影響視訊通話的音視頻同步——翻譯慢兩秒沒關係,原聲照樣即時傳過去,對方先聽到聲音再看到翻譯。代價是多了一條資料通道,伺服器的負載幾乎翻倍——但對於「想練外語但怕完全聽不懂」的用戶來說,這個取捨是值得的。
語言對的動態加載
Hay 支援多達十幾種語言互相翻譯,但不是所有語言對都在本地預載。應用啟動時只加載 UI 所需的語言資源,翻譯模型在配對建立後才動態加載——系統先探測雙方的語言偏好,然後從後端模型倉庫拉取對應的小型翻譯模型到記憶體裡。這也是為什麼某些冷門語言的翻譯延遲會稍長——模型加載本身需要幾百毫秒。
端側美顏:為什麼把特效處理放在手機而不是雲端
Hay 的視訊通話有一個預設開啟的美顏功能——用戶不用手動開關,視訊接通後自動套上一層輕量的膚質平滑和亮度調整。這個選擇背後是一個關鍵的架構決策:所有特效處理都在端側(手機本地)完成,不上雲。
端側 vs 雲端的權衡
把美顏放到雲端的好處是處理能力不受手機硬體限制——雲端 GPU 可以跑更複雜的人臉分割和膚質算法,效果更自然。但代價是每幀畫面要先上雲處理再下傳,延遲至少增加 200ms 以上,對於需要即時互動的視訊聊天來說,這個延遲會讓雙方感覺對話「卡半拍」。
Hay 選擇端側的邏輯很清晰:視訊聊天的核心是「對話節奏不能斷」,美顏是加分項而不是硬需求。如果為了更漂亮的膚質讓對話卡半拍,用戶體驗反而是負面的。所以它用了一個輕量的端側人臉檢測模型——在手機的 NPU(神經網路處理單元)上跑,延遲控制在 20ms 以內,對續航的影響也被壓到最低。
AR 特效的資源閘
除了預設美顏,Hay 還提供 AR 貼紙、變聲等進階特效——這些就比較吃資源了。應用內有一個隱藏的資源閘機制:當檢測到手機記憶體佔用超過 70% 或電量低於 20% 時,會自動把 AR 特效的解析度從 720p 降到 480p,甚至暫時關閉。你可能沒注意到這個降級,但它確保了視訊通話本身不會因為特效處理而崩潰或嚴重掉幀。
計費系統:為什麼是按分鐘扣金幣而不是包月
Hay 的計費邏輯是「免費起步、按分鐘計費」——註冊時送一筆初始金幣,通話開始後每秒扣幾個金幣,餘額歸零通話即刻中斷。很多用戶第一次遇到這種計費方式會覺得有摩擦,但從產品設計的角度來看,它其實是在用一種直接的方式解決「低質對話」問題。
計費作為行為過濾器
包月制的問題是:用戶有動力去「佔著資源不放」——接通後不說話、掛著畫面、甚至開多個視窗同時聊。這會讓配對池裡的有效位置被浪費,真的想聊天的人反而排不上。按分鐘計費等於給每一次連線都標上了「你在花錢」的標籤——用戶會更有意識地讓對話有效率,聊完就掛,給下一個人騰位置。
即時結算的技術挑戰
計費要實時,就意味著每一次通話的開始、結束、秒數累積都要和後端的金幣餘額系統同步。Hay 用的是一個「樂觀更新 + 事後校驗」的模型:本地端先按秒遞增使用量,每 5 秒一次批量上報給後端,後端校驗後扣減餘額。如果雙方金幣同時耗盡,本地端會收到後端的斷線指令,確保兩邊同時掛斷不會出現一邊繼續扣另一邊免費的情況。
這個計費模型的代價
按分鐘計費的摩擦是真實的——有些用戶在聊到興頭上突然被斷線的體驗很差。Hay 的折中方案是推出會員訂閱,會員享受較低的金幣消耗速率和更高的篩選權限,但仍然不是真正的無限制通話。這背後的商業邏輯很有意思:它不追求最大化 ARPU(每用戶平均收入),而是追求最大化配對池的活躍度——讓更多人留在池裡,整個生態才會良性循環。
這套架構告訴我們什麼
把 Hay 的幾個核心設計放在一起看,你會發現它在每個節點都做了「低延遲優先」的取捨:用戶池分片換來了匹配速度,翻譯旁路換來了音視頻同步,端側美顏換來了對話節奏不斷,按分鐘計費換來了配對池的有效位置。每個取捨都有代價,但疊加起來的結果是一個「能跑、能響、能用」的全球視訊聊天應用。
這不代表它沒有問題——弱網下的畫面卡頓、冷門語言的翻譯延遲、計費摩擦帶來的體驗斷層,這些都是用戶每天都會遇到的。但對於一個主打「全球隨機連線」的社交應用來說,先確保核心鏈路不會斷,再談體驗優化,這可能是所有類似產品都要面對的基本課題。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。