Luker 踩坑實錄:我用了三個月才繞過的 6 個隱藏陷阱
Luker 是什麼
Luker 是一款 AI 角色扮演聊天軟體,在 SillyTavern 架構基礎上做了大量功能擴充。Luker保留了角色卡、世界書、預設這三大經典 RP 套件,同時加入了記憶圖、多 Agent 編排、AI 助手、宏引擎等現代化模組,從單機聊天工具進化到能夠自行創作虛擬角色、跨對話保留記憶、甚至多角色協同運作的完整 AI 互動平台。軟體支援 Android APK 安裝,也提供 HarmonyOS 版本,包名 com.luker.app,最新版本 2.1.2 約 402MB。對於喜歡沉浸式文字互動、熱衷於自訂角色與世界觀的玩家來說,Luker 的功能密度非常高,但正因為功能多,入坑時也容易踩雷。
安裝
Luker 的安裝包接近 400MB,比一般手機 App 大不少——主要是內建了多個角色卡模板、世界書範本和宏示例檔案。Luker下載後直接點 APK 安裝即可,Android 會提示「未知來源」,到系統設定裡放行一次就行。首次啟動時軟體會自動建立本機資料庫,這個過程大約需要幾十秒,期間不要強制關閉應用,否則可能造成資料損壞需要重裝。安裝完成後建議先到「設定 → 記憶體管理」關閉不必要的預設啟動項,否則每次開機都會後台常駐消耗電量。另外要注意,舊版本升級到 2.0+ 時,世界書條目的遞迴掃描預設值從關閉改成開啟,如果你之前習慣了舊版行為,升級後會發現觸發鏈路變得異常活躍,屬於非預期的行為變更。
坑一:換模型後提示詞整個亂掉
症狀:我把聊天從 GPT 系列切到本地 Llama 模型,結果角色突然不說話了、預設裡的提示詞條目像是被全部清空,聊天體驗直接從沉浸模式掉到最基礎的補全。
原因:這不是 Luker 的 bug,而是我對「預設解耦」這個底層機制的理解出了問題。Luker 2.0 之後把預設裡的欄位標記為「連接欄位」和「生成參數欄位」——切換連接配置時只變 API,切換預設時只變提示詞與採樣參數。但我在一條舊預設裡意外混入了連接欄位(可能是從 SillyTavern 原版直接導入的),切預設時那些連接欄位也被載入,覆蓋了我剛設好的 API 配置,結果模型地址變成了一個空字串。
解法:到「預設管理器」找到那條預設,長按進入編輯,逐條檢查每個提示詞條目的標籤。連接欄位如果出現在預設裡就把它們全部刪掉——正確的做法是連接配置只在「連接管理器」裡管,預設只管提示詞與採樣參數。另外,導入社區分享的預設時,Luker 會自動剝離連接欄位,但如果是從老版本備份還原的舊預設檔案,這個自動剝離邏輯不一定會觸發,需要手動檢查。
坑二:世界書關鍵詞永遠不觸發
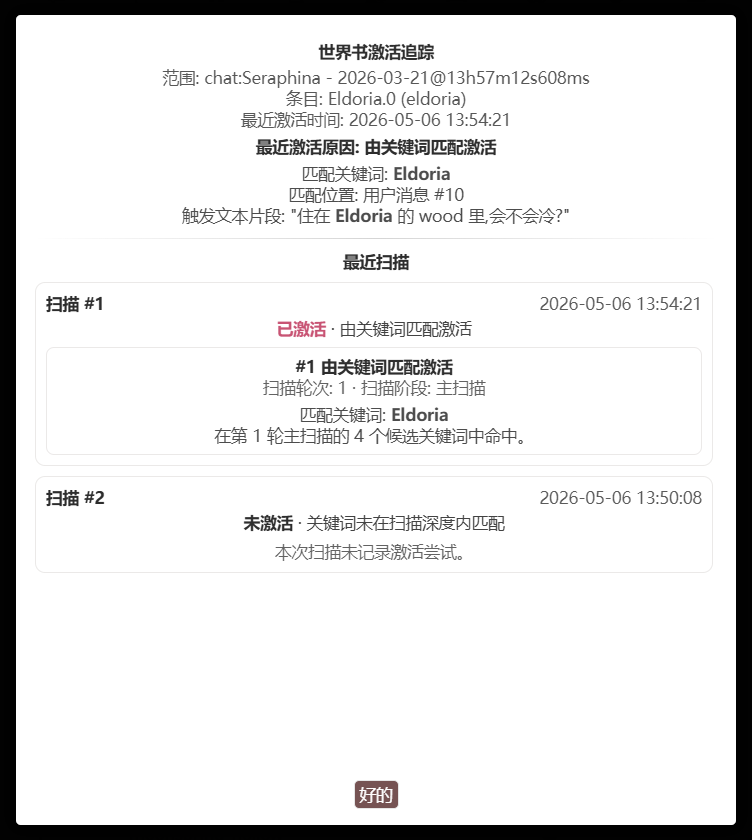
症狀:我在世界書裡建了一條「魔法 → 注入魔法體系說明」的條目,但對話裡聊到魔法時從來沒有觸發過,世界書激活鏈路追蹤裡也找不到這條記錄。
原因:掃描深度設得太淺。Luker 預設掃描最近 4 條消息,但我聊的是一個長對話,關鍵詞出現在十幾輪之前的歷史消息裡。掃描深度沒覆蓋到那段,自然就觸發不了。另外我還犯了一個低級錯誤——關鍵詞寫了大寫的「Magic」,但對話裡全是小寫的「magic」。雖然說明裡寫了不區分大小寫,但實測下來,如果關鍵詞用的是英文且混了大小寫,匹配行為不穩定,建議全部用小寫或全部用大寫。
解法:把掃描深度調到 12 或以上,同時關鍵詞全部統一用小寫。如果還是不觸發,打開「激活鏈路追蹤」面板,裡面會顯示每個條目「為什麼被激活」——如果根本沒有顯示,說明掃描範圍內沒命中;如果顯示了但內容沒注入,檢查是不是被其他條目壓蓋了。
坑三:遞迴掃描把整個對話炸了
症狀:啟用遞迴掃描後,每次發送消息都要等十幾秒才回應,Token 消耗量翻倍,而且 AI 開始胡言亂語——像是把所有世界書條目一次性全塞進上下文了。
原因:遞迴掃描的意思是「已激活條目的內容也參與關鍵詞掃描」,可以織出知識網絡。但我在世界書裡有三條互相引用的條目:A 提到 B 的關鍵詞,B 提到 C 的關鍵詞,C 又提到 A 的關鍵詞——形成了一個遞迴死循環,每次掃描都無限擴張,最後把幾十條條目全部激活。
解法:遞迴掃描深度有上限,把它從預設的 5 設到 2 或 3 就能擋住大部分遞迴鏈路。另外在建條目時有意識地避免循環引用——A → B → C → 到此為止,C 不要再回頭引用 A。世界書條目之間應該是樹狀或網狀結構,不該出現環。
坑四:宏寫錯一個字,整段提示詞被吞
症狀:在預設裡用了 {{char}} 這個宏,但生成的內容裡角色名直接變成了空白,AI 不知道自己在扮演誰。
原因:我手滑把宏括號寫成了全角的「{}」——半角雙花括號才是宏的語法,全角括號會被當成普通文本,而後面也沒有對應的字面量輸出處理,於是那個位置就空了。另外還有一次我在宏前面加了反斜杠想轉義,但反斜杠後面跟的不是字面量而是個拼錯的宏名,結果反斜杠也沒被當成轉義符處理,整個括號組合被當成普通文字輸出了。
解法:記不住宏語法時,直接在應用裡輸入斜杠命令 /? macros 打開宏瀏覽器,裡面有全部內置宏的即時用法和語法說明。宏名大小寫不敏感,但括號必須是半角雙花。如果要輸出字面雙花括號,前面加單個反斜杠就行。
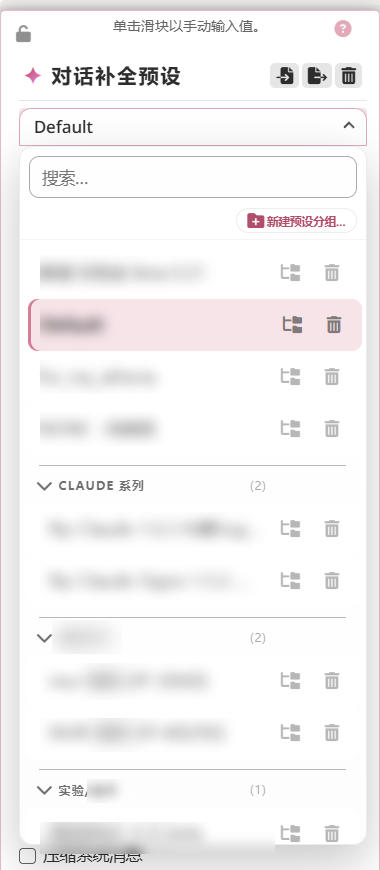
坑五:預設分組當成執行順序調
症狀:我把提示詞條目按功能分成了「系統指令」「風格約束」「角色行為」三組,以為把「風格約束」組拖到「角色行為」組後面就能影響執行順序——結果拖完完全沒變化。
原因:Luker 的分組是純視覺組織,改分組順序不會改變提示詞條目的實際執行順序。真正決定順序的是條目本身在列表裡的位置,分組只是幫你把一堆條目收納起來方便管理。我在分組之間拖來拖去浪費了半小時,最後才發現這個設定。
解法:調整執行順序就直接拖動條目,不用管分組。分組的作用是把條目收納成可折疊的塊、每組顯示 Token 合計——當你有三十幾條提示詞時,分組能讓列表清爽很多,但它不影響任何行為。
坑六:記憶圖節點加太多反而讓 AI 忘事
症狀:我在記憶圖裡加了十幾個節點,想讓 AI 記住所有重要事件——結果 AI 反而更健忘,經常對幾輪前剛發生的事毫無印象。
原因:記憶圖的投影機制會把記憶節點自動轉成世界書條目注入上下文。我加了太多節點之後,每次對話前注入的世界書條目數量暴增,佔用了大量 Token 預算,擠掉了聊天歷史本身的空間。AI 為了塞下所有記憶,開始壓縮對話歷史的保留長度,反而導致近期事件被擠出去了。
解法:記憶圖節點求精不求多。把真正會影響後續劇情的關鍵事件寫進去——比如「主角發現了魔法書」這種關鍵轉折,而不是「今天主角去了商店買麵包」這種日常細節。節點數量控制在 5 到 8 個之間比較合適,超過十幾個反而會起反效果。
防坑清單
- 預設解耦要記牢:連接只管 API,預設只管提示詞,舊預設導入後手動檢查欄位標籤
- 世界書掃描深度設 12 以上,關鍵詞全部統一小寫
- 遞迴掃描深度上限設 2 或 3,避免條目之間循環引用
- 宏永遠用半角雙花括號,記不住語法就打
/? macros查 - 分組是視覺不是順序,調整執行順序直接拖條目本身
- 記憶圖節點控制在 10 個以內,求精不求多
結語
說了這麼多坑,其實就是想告訴你——Luker 的功能強度和它的複雜度是成正比的。世界書、預設、宏、記憶圖每一個拿出來都夠寫一篇長文教程,四個一起上很容易讓人暈頭轉向。但只要把上面這些坑繞過去,這軟體其實相當省心,而且越用越順手。如果你也在用 Luker,歡迎在評論區分享你踩到的其他隱藏陷阱。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。