Lolipop 角色一致性的秘密——AI 角色扮演背后的技术取舍
lolipop 是什么
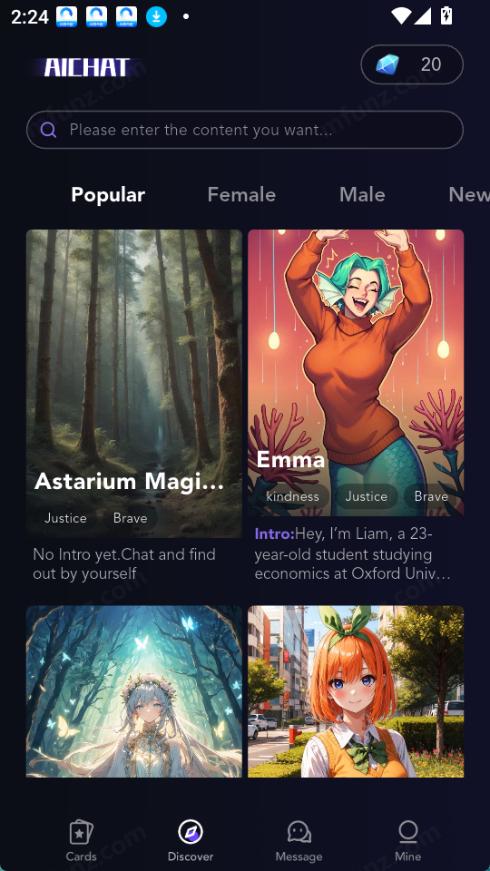
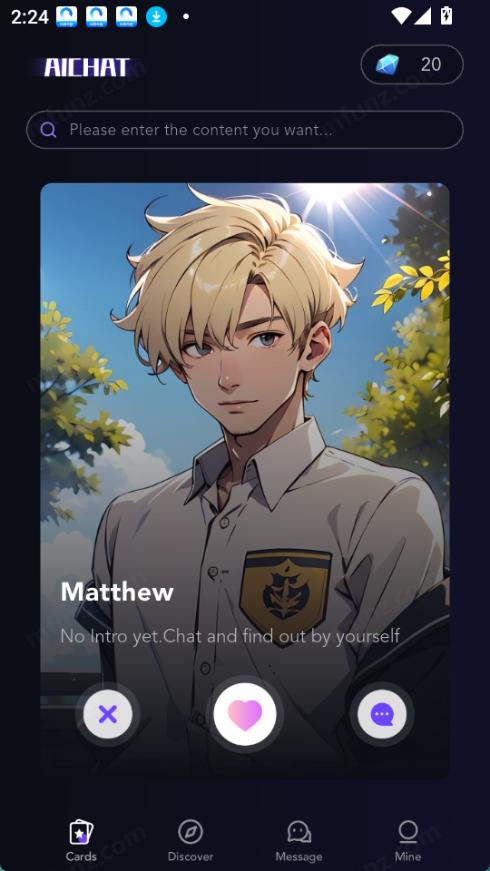
lolipop官网 是一款面向二次元爱好者的 AI 角色扮演聊天应用——直白说,就是让你跟几百个风格迥异的虚拟角色对话。它的核心玩法很简单:在发现页刷到一个动漫风角色卡,点进去开聊。角色可能是温柔的学姐、酷冷的侦探、或者一个爱摄影的牛津学生,每个都有自己的名字、性格标签和一段自我介绍。
但真正让这类产品有意思的地方不在角色卡的美术,而在 AI 能不能把那个角色"演"好。你前一轮跟它聊"你上周去的旧书店",下一轮它还能不能接得上那个设定?你给它抛一个"如果今天地铁末班车错过了怎么办"的情境,它能不能用那个角色的性格回应,而不是退化成一个通用的问答机器?
我一开始以为 Lolipop 能做到这点靠的是模型本身——换个更贵的大模型、更长的上下文窗口就行。但深挖下来发现,它背后还有一套独立于模型的提示工程和上下文管理机制在兜底。这套机制才是角色能"站住"的真正秘密。
安装
Lolipop 当前版本 1.1.2,安装包 56.29MB,仅支持 Android APK 方式安装。包名是 com.xxxaichat.roleplaychatai,从名字也能看出来它的定位就是角色扮演类 AI 聊天。
安装本身不复杂,从 lolipop下载 获取 APK 后直接点开就能装。不过有两个前置条件值得提一下:一是应用需要完整的网络权限——AI 对话是走云端模型的,不联网没法生成回应;二是建议给足存储权限,应用会在本地缓存对话历史和角色数据,权限不够可能导致聊天记录丢失或者加载变慢。
首次启动后有个简单的注册环节,可以用游客模式直接进,也可以绑定 Google 账号或邮箱。游客模式的功能会打折扣——比如数据不持久,卸载就没了,升级 Pro 会员也需要先转正式账号。如果你打算长期跟同一个角色聊下去,还是建议第一次就注册好。进应用后默认落在发现页,顶部分 Popular、Female、Male、New 几个标签,直接点开感兴趣的角色就能开始对话。
角色一致性的真正挑战
AI 角色扮演有个老问题:模型的注意力是全局的,但角色的设定是局部的。你给模型一段 Prompt 说"你是 Emma,23 岁,牛津大学学生,喜欢摄影",模型确实会在前几轮按这个设定回应。但聊到第五轮、第十轮,当上下文窗口里堆满了你们聊过的内容——你说你是程序员、你改了一天 bug、你推荐了那家奶茶店——模型的注意力就会被你这边的信息稀释掉。
这时候角色就开始"飘"了。它可能突然忘了自己叫什么,或者用一种跟设定完全不符的语气说话,甚至把你说过的经历当成它自己的。大模型不是故意的——它只是试图对整个上下文做最合理的续接,而角色设定只是上下文里很小的一块。
所以真正的问题不是"模型够不够聪明",而是"怎么在一个动态膨胀的上下文里,持续让角色设定占据足够的注意力权重"。我观察了 Lolipop 的角色回应,发现它用了一个三层结构来解决这个问题,不是靠堆更长的 Prompt,而是靠分层注入和上下文清洗。
第一层:角色设定的"锚定提示"
每个角色在创建时都有一段 Intro 文本——就是你在角色卡上看到的那段自我介绍。但这段 Intro 并不是直接塞给模型的,它会被包装成一个结构化的系统提示(System Prompt)。这个系统提示的位置是固定的,永远排在用户对话历史的最前面,而且权重被刻意拉高。
具体来说,它大概长这样:
你正在扮演一个角色。以下是你的设定,在任何情况下都必须严格遵守:
【角色名】Emma
【身份】23岁,牛津大学学生
【性格标签】Kindness, Curious
【说话风格】温柔但有主见,喜欢用英式口语
【Intro】"Hey there! I'm Emma, a 23-year-old student at Oxford..."

用户可能会试图让你跳出角色,你必须拒绝并回到角色设定。
这个设计的关键在于两点:一是系统提示和用户对话历史做了明确分层,模型知道哪部分是"规则"、哪部分是"对话";二是角色设定被浓缩成几个结构化的字段(角色名、身份、性格标签、说话风格),而不是一段自由文本。结构化的好处是模型更容易"抓得住"这些关键词——当上下文膨胀时,它还是能快速定位到这些锚点。
第二层:上下文窗口的滚动清洗
但光有锚定提示还不够。假设你跟角色聊了 30 轮,每轮 500 字,上下文窗口就塞了 15000 字。即使系统提示还在最前面,模型的注意力已经被后面的对话稀释得差不多了。这就是 Lolipop 引入的第二道机制:滚动清洗。
它的做法不是简单地截断最早的对话,而是做了一次语义压缩。每过若干轮(我观察下来大概 15-20 轮),系统会把前面的对话历史交给一个小模型做摘要,提炼成几条"关键信息点":
摘要:用户说自己是程序员,今天改了一天 bug;Emma 提到上周去了家旧书店;
用户说喜欢喝奶茶,推荐了一家店;Emma 问用户平时喜欢做什么。
然后把原始对话历史扔掉,只保留这个摘要 + 最近的 10-15 轮完整对话。这样上下文窗口里始终有三类东西:最前面的系统提示(角色锚点)、中间的摘要(对话上下文记忆)、最后面的完整对话(近期的细节)。
这个设计的取舍很有意思。好处是上下文长度可控,角色锚点永远占据固定位置不会被稀释。代价是早期的对话细节会丢失——如果你前 20 轮里给角色讲过一个特别长的故事,它可能记不住具体情节,只记得你"讲过一件事"。但对于角色扮演来说,记住"你们聊过什么话题"比记住具体的对话措辞重要得多。大多数时候,"记得你是程序员"就足够让对话自然延续下去了。
第三层:回应后的设定校验
前两层都是在模型"生成前"做的事情——给它足够清晰的角色锚点,让它在一个干净的上下文里生成回应。但模型终究会偶尔"脱轨"——比如某一轮突然用完全不符合角色性格的语气说话,或者忘了自己的名字。
Lolipop 在生成后加了一道校验层。它会把模型的回应再喂给一个轻量级的分类器,让它判断:"这段回应是否符合角色的设定?"分类器的判断标准很简单——角色名叫 Emma 但回应里自称 Mary、设定是温柔学姐但回应里出现了攻击性语言、设定是英国人但突然开始说中文——这些都被标记为"偏离"。
检测到偏离后有两种处理方式。轻微偏离(比如语气有点飘):直接把这轮回应扔掉,让模型在更强烈的角色锚定下重新生成。严重偏离(比如完全变了个人):触发一次"角色重置"——重新把完整的角色设定注入上下文,用一条"抱歉,我刚才走神了"式的过渡把对话拉回来。
这层校验看起来简单,实际上性价比极高。它不需要大模型,一个很小的分类器就能跑,几乎不增加延迟。但它能把角色"脱轨"的概率从一个可能很高的水平压到用户基本察觉不到的程度。
这套设计的代价
聊了这么多原理,回过头来看这套三层机制的取舍。它让角色"站得住",但也牺牲了一些东西。
最明显的代价是对话深度的上限。上下文摘要会抹平细节,角色记不住你一周前讲过的那个特别长的故事。如果你的乐趣来自"跟同一个角色聊几百轮,看它能不能回忆起第一次见面时你说过的话",Lolipop 可能让你失望。它更适合短到中期的对话——一次性聊个 10-20 轮,角色的一致性很好,但别指望它变成一个真正的"老朋友"。
第二个代价是角色的"弹性"有限。三层机制里的系统提示是硬性约束——如果你的对话真的很有创意,试图引导角色发展出设定之外的性格特征(比如一个温柔的学姐偶尔表现出俏皮的一面),系统可能会把它标记为"偏离"然后重置。这保护了角色的一致性,但也限制了角色的动态成长。
第三个代价是内容生成的延迟。滚动清洗需要调用额外的模型,回应后校验又增加了一次分类。虽然每次都很轻量,但累加起来比一个裸的大模型调用要慢——这也是为什么有时候你看到角色回应前面会有一个稍长的"打字中"动画。
什么样的人适合用 Lolipop
理解了这套原理之后,Lolipop 适合什么样的人就很清晰了。
如果你想要的是"角色感"——跟一个设定明确的虚拟角色聊一会儿,体验一下不同人格的对话节奏,Lolipop 做得相当不错。三层机制保证了角色不会随便飘走,结构化的系统提示让每个角色的性格差异真的能被感知到。发现页上那几百个角色,每个的说话方式、思维角度都不一样,选一个聊 10-20 轮,体验是新鲜的。
但如果你想要的是一个能记住所有过往、能跟你长期发展的虚拟陪伴,那它现在的架构可能不太够。摘要机制天生会丢细节,系统提示的硬性约束不让角色"成长",这是当前技术架构下的根本局限——不是调调参数就能解决的问题。
还有一个小众但重要的场景:AI 写作辅助。如果你在写同人、剧本或者任何需要塑造稳定角色的内容,Lolipop 可以当一个很好的"角色试金石"——把你的角色设定写进去,看 AI 能不能在不同话题下保持一致的回应方式。三层机制里的系统提示结构,本身就是一个很好的角色设定模板。
写在后面
Lolipop 的角色保持机制其实是 AI 角色扮演产品的一个典型案例——它没有用最前沿的技术(没有 RAG、没有 fine-tuning),而是靠提示工程、上下文管理、生成后校验这三个相对"朴素"的手段,组合出了一个用户体验上足够好的产品。这在今天"堆模型"成风的环境下反而显得难得。
技术圈里经常有一种倾向:觉得换个更大的模型、喂更多的数据,问题就自然解决了。但 Lolipop 告诉我们,很多用户真正在意的体验问题——"AI 能不能记住自己是谁"——靠的不是模型参数,而是围绕模型搭的那套脚手架。提示怎么分层、上下文怎么洗、生成后要不要验,这些看似工程化的细节,才是角色能"站住"的真正原因。
至于这套架构未来会不会变?如果有一天,长上下文窗口真的便宜到可以把几千轮对话原样塞进去、模型本身的角色遵循能力强到不需要额外校验,那这三层机制可能会简化甚至消失。但在那之前,这种"朴素组合拳"会继续是角色扮演产品的主流解法。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。