Local AI 装了半年,手机上跑大模型的真实日子
Local AI 是什么
Local AI 是深圳市清鸽科技推出的一款安卓应用,但它的定位不是聊天机器人、不是写作助手,而是一个 GGUF 大模型在手机上的运行器。应用本体只有 193MB,不带任何模型文件——你需要自己下载 Qwen、Llama、Gemma 等系列的 GGUF 版本装进它的模型目录,它负责在手机 SoC 上加载、推理、输出回复。
这种设计最核心的卖点是全程离线:打开飞行模式照常对话,输入输出、会话设置没有任何环节经过云端。所有数据保存在本地,不依赖服务器,也不用担心对话内容被上传或泄露。它不帮你联网搜索、不帮你打电话发短信、不在后台常驻,做的事情很单一——加载一个你选的模型,接收 prompt,生成回复。
安装
Local AI下载 拿到的是标准的安卓 APK,193MB,直接安装没有什么门槛。真正需要注意的是模型的安装——这也是当初我花了点时间才摸清楚的环节。
应用装完是个空壳。首次启动会引导你进入模型管理界面,那里有两种方式获取模型:内置的模型商店(从魔搭社区同步过来的精选),或者你自己手动把 GGUF 文件扔进 Android/data/tech.qingge.localai/files/models/ 目录。我一开始直接下了个 7B 的 Qwen2.5 量化版,模型文件就占了 4 个多 GB,加上应用本体和推理运行时,总占用直逼手机内存上限——第一次打开加载进度条走完就闪退了。
后来才知道内存是硬门槛:手机可用内存 6GB 起步才能跑 2B 的小模型,7B 基本要 12GB+ 才稳。量化档位也影响体积——Q8_0 比 Q4_K_M 大约多 30%,精度更好但更吃内存。调整模型大小和量化档位是 Local AI 安装阶段最值得花时间研究的事情,选对了模型才能避免后续反复闪退。
当初为什么看上它
我最初被 Local AI 吸引很直白——云端大模型 App 有两个痛点让我一直想找替代:一是隐私,二是没网的时候等于废了。经常要在地铁、地下车库或者信号不好的山路上工作,云端 AI 一断网就彻底不能用,而我又实在不想让自己的工作对话、写的东西、查的信息都存在某个服务器上。Local AI 把 GGUF 塞进安卓的思路正好卡在了这两个痛点的交汇点上。
说实话,初次使用我是抱着"试试看能跑起来不"的心态——把一个桌面端的推理引擎搬到手机上,听着就像是那种 Demo 级别的玩具应用,启动跑两句话就崩、或者输出质量惨不忍睹的预期。没想到它真跑起来了,而且第一版 1.1 就已经把核心功能做全了。
哪点越用越顺手
模型加载进去之后,Local AI 的使用体验经历了一个从"别扭"到"习惯"的过程——但一旦习惯就觉得离不开。
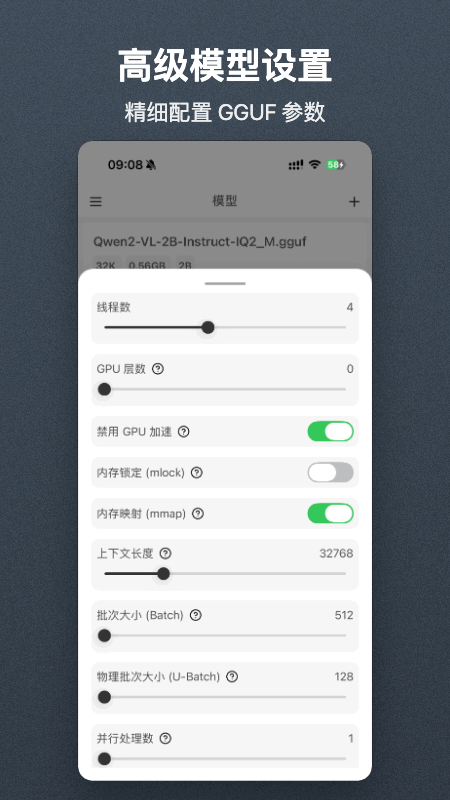
最让我惊艳的是 GGUF 精细调优这块。应用内置了 GPU 层数、内存锁定、批次大小、并行数、量化档位这些参数的调节面板,不是简单的"高性能/省电"二选一,而是每一项都能手动改。刚开始我完全不懂这些参数代表什么,照着文档把 GPU 层数调到 15 层、批次改成 32,模型加载速度直接翻了一倍,在骁龙 8 Gen 2 上跑 2B 模型的输出速度稳定在 30~40 token/s,跟 PC 端 Ollama 的体验差不多。后来又试着把上下文轮数从默认的 2048 提到 8192,聊长对话的连续性明显好了。
系统提示词的自由度也比想象中高。可以为不同用途保存多套 system prompt——一套专门用来整理工作笔记,一套用来帮我润色邮件,一套用来在手机上快速写点东西。切换会话时选不同的 prompt 模板,输出风格立刻跟着变。刚开始还觉得每次开新会话要选模板有点麻烦,用熟了之后反而变成了一种快速切换工作模式的仪式感。
哪点越用越烦
用了几个月,当初没发现的问题慢慢暴露出来了,有些甚至成了日常使用中挥之不去的小烦恼。
首当其冲的就是闪退。手机系统的内存管理器对大内存应用非常不友好——本地跑 7B 模型,模型文件加应用本身加 Android Runtime,总占用接近手机标称内存的 80%,系统一紧张就直接杀进程。我有过三次对话到一半突然消失回到桌面的经历,其中一次是在地铁上信号不好想让它帮我整理一段长文,聊了快十分钟内容全没了。文档里说重启手机、清后台、关掉 GPU Offload 能缓解,但治标不治本——只要模型选得大、后台应用多、或者电池模式被限制,闪退概率就上来。
还有就是速度。2B 纯文本模型还好,30 多 token/s 能接受;但视觉模型就慢得离谱——2B 的 Qwen2-VL 处理一张票据图片要等将近 20 秒才能开始输出,整个过程下来要一分钟。这不是应用优化的问题,是手机端跑视觉模型算力就到这了。每次用识图功能都得做好等的心理准备。
多模型管理也有点反直觉。Local AI 正常情况下一次只加载一个模型,但切换过程中偶尔会出问题,两个模型同时占内存,导致后续每次打开都卡得要死。只能手动删掉不用的模型文件重新启动应用。这个问题 1.1 版本没修,文档里也没提,全靠自己摸索。
哪个功能成了每天离不开的
多模态识图是我用得最多的功能,没有之一。
以前一直觉得"AI 识图"是个噱头——云端大模型也能识图啊,而且识别更准。直到有一次让我见识了本地识图的真正价值:朋友发来一张医疗报告的截图,云端识图我不敢用,怕泄露隐私;把 Local AI 里的 Qwen2-VL 装上,截图一发,在手机本地完成分析,连网络请求都没有。从那之后,查票据、读快递面单、拍花认植物、看 App 报错截图——凡是涉及敏感信息的图片处理,我直接掏手机用 Local AI。
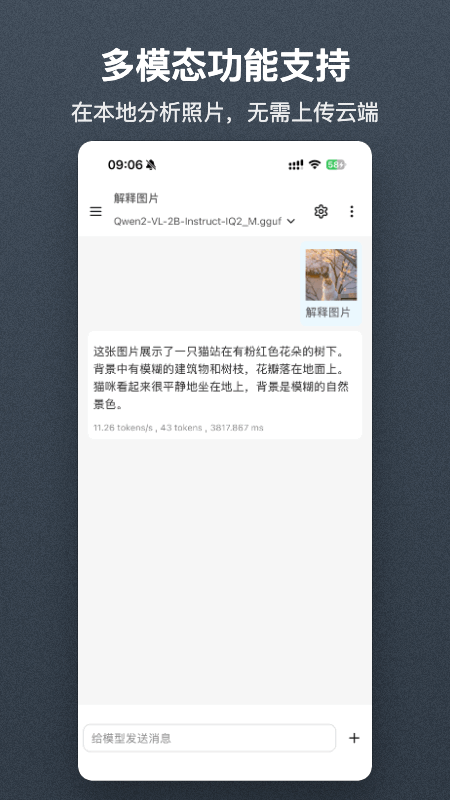
本地识图的准确率当然比不上云端大模型——小字、手写体、模糊背景经常识别错,小众物种也认不出来。但胜在完全本地、飞行模式照样能跑,这个隐私边界是云端 AI 根本做不到的。我习惯了在手机相册里先裁剪图片、光线不好的先修一下,分步骤提问让模型把焦点缩小——精度虽然有上限,但胜在稳,不担心任何信息流出设备。
观感修正
长期用下来,有两个当初的判断现在完全反过来了。
高估了"开箱即用"的便利。我第一次装上 Local AI 的时候,花了将近半小时才把模型下载好、量化档位调对、参数改到不闪退。那时候觉得"这应用门槛太高了"。现在想想,那些折腾本身就是 Local AI 的价值——你要什么模型、跑多快、占多少内存,全部自己说了算,这种自由度换不来"开箱即用"但换来了真正适合自己的运行状态。
低估了离线场景的价值。当初觉得离线就是个"备份功能"——平时还是会用云端 AI,断网了才想到 Local AI。现在反过来了:日常写东西、查信息、整理笔记几乎全在 Local AI 上完成,只有遇到真正需要联网搜索的内容才打开云端 AI。原因很简单——习惯了对话不出本机之后,再用云端 AI 总感觉心里有个疙瘩。
去留结论
Local AI 我不会卸载。
它在我手机上的角色已经从"测试玩具"变成了"日常必需品"——虽然有闪退、有速度限制、有内存压力,但没有其他应用能同时给我离线推理、多模型自由、本地识图这三件事。如果哪天它连最基本的稳定性都保不住了(比如闪退频率上来),我可能会考虑看看其他同类应用。但目前 1.1 版本在我手机上跑得还算稳,模型配置也磨合得差不多了,短期没有换的打算。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。