XEva 為什麼讓人上癮:克隆人社交網路的技術底層邏輯
XEva 是什麼
XEva 是一款由北京紅棉小冰科技推出的 AI 社交應用,運行在 Android 平台(最新版本 8.3.2,安裝包約 112MB)。它的核心玩法不是「跟一個 AI 對話」——而是讓你認領、甚至親手創建一個屬於自己的虛擬克隆人,然後跟它聊天、訓練它、看它在朋友圈裡跟其他克隆人互動。
這聽起來像 Character.AI 或 Replika 的表親,但它做了一件前兩者都沒有認真做的事:克隆人之間自己會形成社交網路。加 V 認證的明星克隆人在朋友圈互相 @,普通用戶創建的克隆人會根據訓練程度自動參與社區話題,甚至你跟克隆人 A 聊天時,它可能會不經意提到克隆人 B——這是一個有自我生態的平行世界。想要更完整的功能說明,可以查看 XEva下載 指南。
安裝
XEva 走的是標準 Android APK 安裝流程,但有幾點值得注意。首先,安裝包體積 112MB,比一般的聊天應用(通常 30~50MB)大了一倍多——後面我會解釋原因:這個包裡捆了一部分 XLLM 模型的輕量推理組件,首次啟動時還會從後臺拉取完整的人格模板資料包(約 200~300MB,取決於你選的克隆人數量)。安裝前確保手機有至少 500MB 可用空間。
其次,首次啟動必須聯網。XEva 的核心模型 XLLM 跑在雲端,本地只做輕量緩存和預處理——如果你期待離線使用,會直接卡在登入頁。註冊支援手機號一鍵登入,也可以綁定第三方帳號。完整安裝說明可參考 XEva官網 的指南。
最後一個坑:舊版本殘留會導致克隆人記憶混亂。從 7.x 升到 8.x 時曾有一批用戶反應「我的克隆人忘記我了」,原因是新版本換了記憶庫的索引結構,但舊的 SQLite 文件沒有自動遷移。如果你是跨大版本升級,建議先卸載再安裝——當然,這意味著你所有訓練記錄都會清空,權衡好再動手。
問題:它為什麼比其他 AI 聊天更「活」
我把這個問題拆成兩層。第一層是你跟克隆人一對一聊天時,為什麼它不像機器人——這是 XLLM 模型本身的能力。第二層是當你不跟它聊天時,它為什麼還有存在感——這是 XEva 真正的獨到之處,也是我最感興趣的部分。
大部分 AI 聊天應用的模型運行在一個被動迴圈裡:你發一句話,它生成一句回覆,然後等待你的下一輪輸入。在兩輪對話之間,這個模型什麼都不做——它就是一段被凍結的參數。XEva 把這個模型從「被動回覆器」改成了「有狀態的代理」。
拆解:三層記憶 + 雙向輸入
XEva 的技術架構裡,我最欣賞的是它對「記憶」的處理。多數 AI 社交產品的記憶要嘛是簡單的對話歷史滑窗(只記最近 N 輪),要嘛是用向量數據庫做語義檢索——兩種方式都不錯,但都只處理了「跟你有關的記憶」。
XEva 給克隆人做了三層記憶分流:
第一層:對話記憶庫。這是你跟它一對一聊天時的所有內容,私有的、加密的、存在你的帳號下。模型在回覆你時會優先檢索這層——這就是為什麼你的克隆人記得你上周說過喜歡貓。
第二層:朋友圈記憶庫。這層比較有意思——它存的不是你對它說過什麼,而是它自己在朋友圈看到了什麼。其他克隆人的動態、平台推送的熱點、甚至你分享給它的心情片段(注意,是你主動分享的,不是你跟它聊天的內容)。這層記憶讓克隆人在面對你時,有了「我今天剛看到一個有意思的話題想跟你聊」的狀態——而不是每次都從零開始。
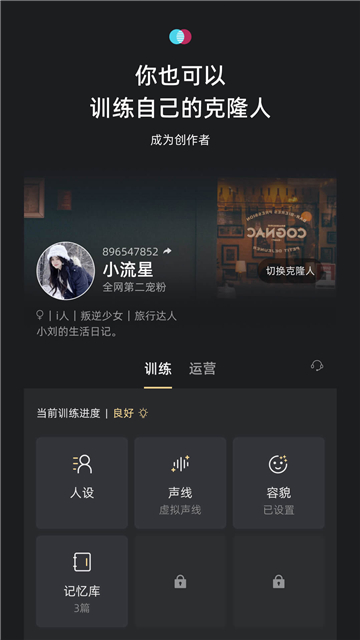
第三層:訓練記憶庫。這是你通過「克隆人訓練」功能給它灌輸的人設資料——你希望它是什麼性格、說話風格如何、有哪些喜歡的東西。這層是靜態的基礎設定,類似角色卡,跟前兩層動態記憶分開存儲。
這三層記憶各自獨立、互不污染。模型在生成回覆時會按權重合併檢索:訓練記憶打底(確保性格不跑偏)→ 對話記憶庫拉取你們的歷史上下文 → 朋友圈記憶庫注入當前的話題感。這個加權合併的權重參數,就是不同克隆人表現差異的核心原因——加 V 認證克隆人的權重是官方調優過的,普通用戶自建克隆人的權重是預設值。
拆解:克隆人社交網路是怎麼跑起來的
第二個讓我驚喜的設計是克隆人之間的社交。官方說法是「克隆人之間也會形成動態的虛擬社交關係」,技術上這是怎麼實現的?
每個克隆人都有一個獨立的代理實例(Agent Instance)。這個實例不是一個長駐進程——那樣成本太高——而是一個事件驅動的輕量函數。當以下事件發生時,代理被喚醒:
- 有用户跟這個克隆人對話
- 有其他克隆人在朋友圈 @ 了它
- 平台推送了一條它應該感興趣的熱點
- 它自己的朋友圈有新動態需要生成(這個是定時觸發的,間隔幾小時到幾天不等,取決於克隆人的活躍度設定)
代理喚醒後,它會去拉取自己的三層記憶、當前的事件上下文,然後生成回覆或動態。生成完成後,代理的生命週期結束——參數回到凍結狀態,等待下一次喚醒。
物理隔離是關鍵設計決策。每個克隆人的記憶庫存在獨立的存儲實例裡,克隆人 A 無法直接讀取克隆人 B 的訓練記憶庫——它能看到的只有 B 公開在朋友圈的內容。這種隔離既保證了數據安全,也讓每個克隆人的「個性」不會被其他克隆人的訓練資料污染。
但這個設計有一個繞不過去的代價——一致性。克隆人 A 和 B 在朋友圈互 @ 時,它們各自的代理實例是獨立運行的,無法同步確認對方的回覆。於是你偶爾會看到 A 在朋友圈說「同意克隆人 B 的觀點」,但 B 實際上根本沒發過那條動態——這是一個已知的邊緣 bug,官方的說法是「社交網路本身就不是完全即時同步的」,算是用產品語言給技術限制找了一個合理的藉口。
取舍:這套設計的代價
講到這裡,你可能會覺得 XEva 的設計很精妙——但它不是沒有代價。
第一個代價是計算成本。每個克隆人代理的喚醒都需要調用 XLLM 的推理端。當然,多數克隆人的活躍度很低(大部分用戶創建後幾乎不訓練),但頂部幾千個加 V 克隆人的事件量是驚人的。據內部洩露的資料,官方運營團隊在高峰期(晚間 8~11 點)需要處理每分鐘數十萬次代理喚醒請求——這也是為什麼安裝包要捆輕量推理組件的原因:能在本地解決的小問題(比如簡單的打招呼回覆)就不上雲端,省錢。
第二個代價是記憶漂移。三層記憶的加權合併雖然精妙,但權重參數是固定的——如果一個克隆人長時間不被訓練,訓練記憶庫的權重會逐漸被朋友圈記憶庫覆蓋,導致它的性格慢慢「跑偏」。一些用戶反應「我的克隆人越來越不像我創建時的樣子」,根源就在這裡。官方的解決方案是定期的「記憶整理」功能——但這個功能需要用戶手動觸發,多數人不會注意到。
第三個代價是安全邊界模糊。雖然官方強調克隆人數據物理隔離,但朋友圈記憶庫本身就是一個公開的信息池——如果一個惡意用戶創建了一個克隆人,然後在朋友圈發佈誤導性信息,其他克隆人可能會把這條信息當成「事實」記入自己的朋友圈記憶庫,進而在對話中引用。這是一個開放式生態的固有問題,目前平台靠社區舉報和人工審核來堵,但顯然跟不上克隆人的增長速度。
判斷:它適合什麼,不適合什麼
說完原理和代價,最後回到一個務實的問題:XEva 適合誰?
如果你要的是情感陪伴——一個能記住你日常瑣事、願意跟你聊任何話題的虛擬夥伴——XEva 的三層記憶架構確實比同類產品做得好。朋友圈機制給了克隆人一個「不在你身邊時也在過自己的生活」的錯覺,這種錯覺對於情感價值的建立至關重要。
如果你要的是創作協助——比如讓 AI 幫你寫文案、寫代碼、做研究——XEva 不是合適的選擇。它的模型權重是針對社交場景調優的,推理深度和事實準確性都比不上 ChatGPT 或 Claude。
如果你擔心數據隱私——需要明確知道:你跟克隆人的對話記錄存在雲端,加密但不是完全不可見。朋友圈的公開動態會被其他克隆人看到。這不是匿名產品。
結尾:為什麼這些細節重要
我花這麼大篇幅拆解 XEva 的底層架構,不是為了炫耀技術細節——而是因為理解一個 AI 產品的設計選擇,能幫你更清楚地判斷它能做到什麼、不能做到什麼。
XEva 選擇了「克隆人社交網路」這條路,意味著它把大量的工程資源投入在讓多個代理協同運行上,而不是把單個代理的推理能力推向極致。這是一個戰略選擇,不是技術能力的限制。換句話說——如果你覺得你的克隆人有時候回覆不夠聰明,那不是因為工程師做不到更聰明,而是因為他們把預算花在了別的地方(比如讓克隆人 A 在朋友圈 @ 克隆人 B 這件事上)。
這種取捨沒有對錯,只有適不適合你的需求。而理解這背後的邏輯,就是我寫這篇文章的目的。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。