Wan2.2 嵌进我的短视频生产链:从商品图到成片少了三次手动复制
Wan2.2 是什么
Wan2.2 是通义万相推出的开源 AI 视频生成大模型,涵盖文生视频(T2V)、图生视频(I2V)、对口型(S2V)和角色动画(Animate)四条能力线。和它的前身 Wan2.1 相比,2.2 最大的升级点是引入了一套带精细标注的美学数据集——包含光照、构图、色调、对比度等维度,这让模型生成的画面不仅"能动",而且"好看"。
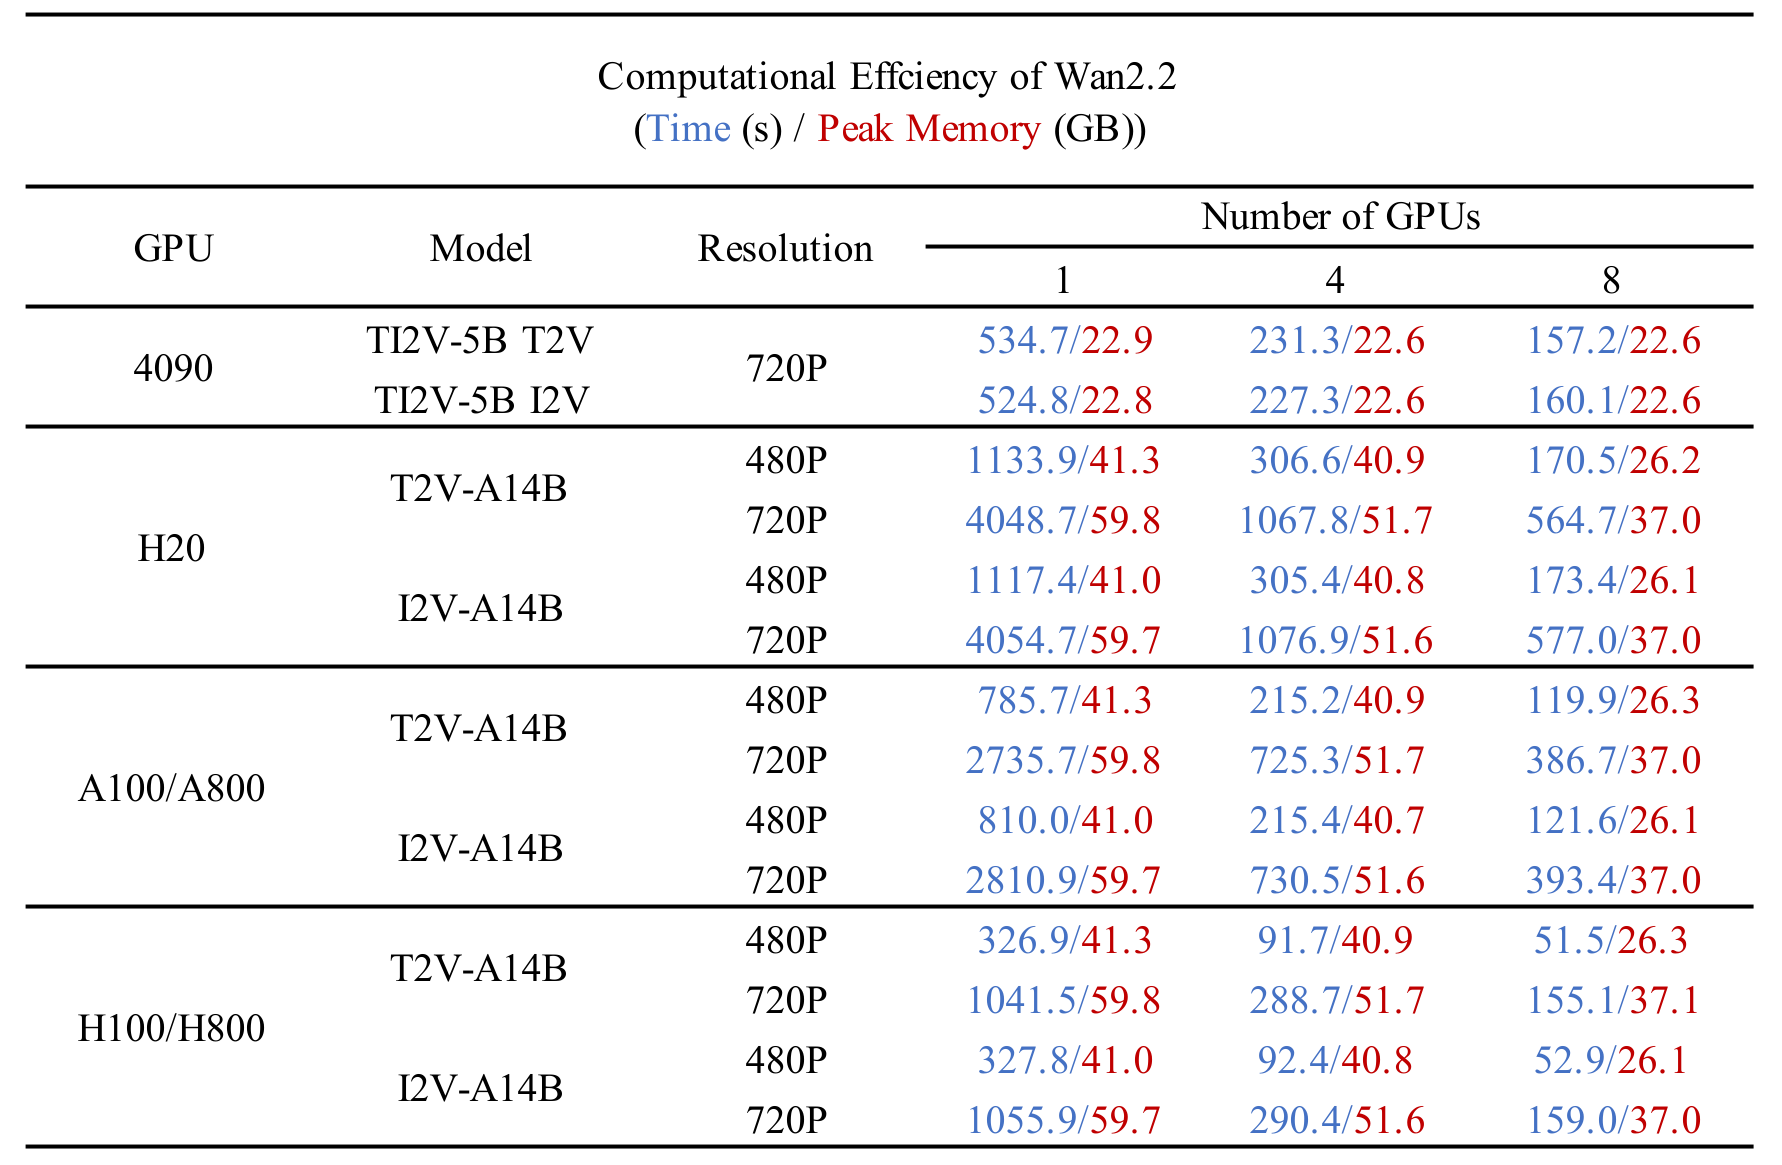
它有两种用法:一是本地部署Wan2.2(需要 CUDA GPU,4090 跑 I2V-5B 勉强够用,H100 体验更好),二是直接走阿里云百炼的云端 API。对不想折腾环境的人来说,云端是更省心的选择——按调用量计费,不用管显存够不够、FlashAttention 装没装。
安装
Wan2.2下载 的 Android APK 版(3.43.2,64.42M)。手机上装这个有个独有的前置条件:Android 12 以上需要在设置里给浏览器或文件管理器开启"允许安装未知应用"权限,光开系统的"未知来源"开关不够,Google 在 Android 11 之后改成了逐应用授权。
具体路径:设置 → 应用管理 → 找到你用来下载 APK 的那个浏览器 → 安装未知应用 → 允许。开了之后回来点 APK,一路下一步就行。首次启动会弹隐私协议确认和模型资源下载提示——别跳过那个下载提示,它会在后台拉一个核心模型包,不拉完很多功能是空壳。
如果你装过之前的版本,建议先卸载旧版再装新版。通义的 APK 升级偶尔会遇到旧版本残留导致启动白屏的问题,卸载重装是最快的解决方式。
旧流程:我之前是怎么做短视频素材的
我每周要出 3~5 条商品展示短视频,给自家公众号和视频号用。内容其实很简单——一张商品静态图,配上一个缓慢的推镜头,加上几句口播文字,10~15 秒的短视频。听起来简单,但以前我要这样干:
- 商品图丢进剪映,手动加关键帧做一个推镜头效果——大概花 15 分钟调参数,还要导出试看
- 口播文字用另一个软件转成音频,手动对齐到视频时长——又 10 分钟
- 合成导出,检查一遍有没有音画不同步,调整,再导出——第三次手动复制路径
三步手动、两次导出试看,一个小时能做出一条就算快的。卡壳的地方在于:每一步都要人盯着——剪映的推镜头参数不会自动根据商品图的构图调整,口播时长和视频时长的对齐每次都要手动拉,没有自动化入口。
新流程:把 Wan2.2 插进哪一环
我现在的流程是这样的:
商品图 → Wan2.2-I2V 生成带推镜头的动态视频 → 百炼 S2V 做口播对齐 → 直接成片
核心变化是把原来三步里的前两步合并成一次 API 调用——Wan2.2 的 I2V 能直接在 prompt 里描述运镜,生成的视频本身就带着推镜头,不用再进剪映加关键帧。然后口播用 S2V 的两步接口:先做人脸检测(wan2.2-s2v-detect)拿到裁剪后的人脸图,再用检测后的图 + 口播音频调 wan2.2-s2v 生成对口型视频。
上下游衔接的关键点:
- 商品图直接从团队的云盘(飞书多维表格)里取,我写了个很薄的 Python 脚本,读表格里的最新一行图片字段,拿到图片 URL
- 口播音频用现成的 TTS(字节的火山引擎),脚本直接拼好文字调接口,返回音频 URL
- 然后把图片 URL 和音频 URL 按顺序丢进 Wan2.2 的 API 链,全部异步提交,主程序只负责轮询结果
整个流程跑起来大概 4~6 分钟,中间不用人盯着。少了两次手动复制(商品图路径、口播音频路径),多了一次脚本自动轮询。
实操细节:最容易断链的两个环节
断链一:百炼 API 的地域三绑定
这个是我跑了三次才搞明白的坑。百炼调用 Wan2.2 的三个要素必须同地域:模型部署地域、API Endpoint URL 地域、API Key 的地域。任何一个错了直接报 400,没有任何有意义的错误信息。
我的 API Key 是新加坡(ap-southeast-1)的,但一开始模型部署在华北(cn-beijing),Endpoint URL 我随手抄了个 cn-beijing 的,结果就是每次调用都 400。排查花了半小时才定位到地域不一致。
正确做法:先登录百炼控制台,确认 Wan2.2 模型部署在哪个地域,然后 Endpoint URL 里的 region 字段和 API Key 地域全部对齐。Endpoint 格式是 https://{WorkspaceId}.{region}.maas.aliyuncs.com,region 值要和模型部署地域逐字匹配。
断链二:异步任务的轮询策略
Wan2.2 的云端 API 全部是异步模式——提交后返回 task_id,然后轮询 task_status。轮询间隔不能太短(会被限流返回 429),也不能太长(等得难受)。
我用的策略是指数退避:第一次等 2 秒,第二次等 4 秒,第三次等 8 秒……最长等到 30 秒,超过 30 秒就固定 30 秒间隔。如果返回 429(限流),再加一个额外的 2 秒冷却再继续。实测 I2V 任务平均 1.5~3 分钟完成,轮询开销不大,但并发多任务时必须控制好节奏。
还有一个细节:百炼的 RPS(每秒请求数)限制很紧——T2V/I2V Plus 系列只有 1~5 RPS,同时提交三个任务就可能被限流。我的做法是串行提交,一个任务完成(或失败)了再提交下一个,省掉限流重试的麻烦。
效果与边界
这套流程跑通之后,一条 10 秒的商品展示短视频从 1 小时压到 6 分钟以内,而且中间没人盯着。批量出 5 条的话,以前要 5 小时,现在 25 分钟就能跑完。
但它不是什么场景都划算的。我总结了几个边界:
什么时候用:商品图本身构图不错(主体清晰、光照均匀)、口播文字不超过 3 句、视频时长 5~10 秒——这种标准化的短素材,Wan2.2 生成的运镜足够用,不用再手动调。
什么时候别用:商品图是多人合影(S2V 检测大概率失败)、需要精确控制运镜起止点(比如推到商品 logo 停住)、或者视频要 15 秒以上——Wan2.2 的运镜描述是自然语言,控制粒度比剪映的关键帧粗,精确卡点还得手动来。
还有一个隐性成本:百炼 API 的计费。I2V 按秒计费,720P 大概 0.02 元/秒,10 秒就是 0.2 元,跑 5 条就是 1 块钱。如果每天批量跑 20 条,一个月大概 600 块。成本不算高,但如果以后业务扩到每天 50 条以上,本地部署反而可能更划算——前提是你有一块 4090 以上的显卡。
写在最后
这套流程的核心不是"用 AI 代替人",而是把原来必须人手盯着的三个串行步骤,改成一次脚本提交的三个异步任务。人只在开头提供商品图和口播文字,中间完全可以去做别的事。Wan2.2 在其中扮演的角色很明确——代替剪映的运镜关键帧 + 口播对齐,不是代替全部创作。
我也试过长视频(30 秒)和复杂运镜(先推近再平移),效果不太理想——Wan2.2 的运镜能力还没到闭源模型的精细度,长视频的一致性也会漂移。但如果你的需求就是我这种:短、标准化、批量出,它目前是开源模型里性价比很高的选择。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。