OpenLess 词典热词机制:ASR 预算不够时,怎么让每一个词条都值回票价
OpenLess 是什么
OpenLess 是一款远程语音唤醒的输入法工具——按住热键说话,松开后自动把口语转成排版规整的文字,直接插入光标所在位置。它的核心卖点是把「语音输入」这件事从「只能对着输入法界面说」解放出来:在微信、邮箱、Notion、CLI 里都能按住同一个全局快捷键录音,系统后台帮你走完录音 → 转写 → 润色 → 插入的整条链路。
这类工具的护城河不在 ASR 本身(各家 ASR 准确率差距在持续收窄),而在「录完之后怎么把一段口语变成干净的文字」以及「怎么让它在你的专业领域里好用」——后者就是 OpenLess 词典系统要解决的事。
安装
OpenLess 在 Android 上以 APK 形式分发,安装包 17.54M,当前版本 1.3.11。安装本身没什么特别的——OpenLess下载 APK 到手机,允许「未知来源」安装,点一下就完。真正需要提前知道的是装完之后的首次配置流程,以及几个容易踩的坑。
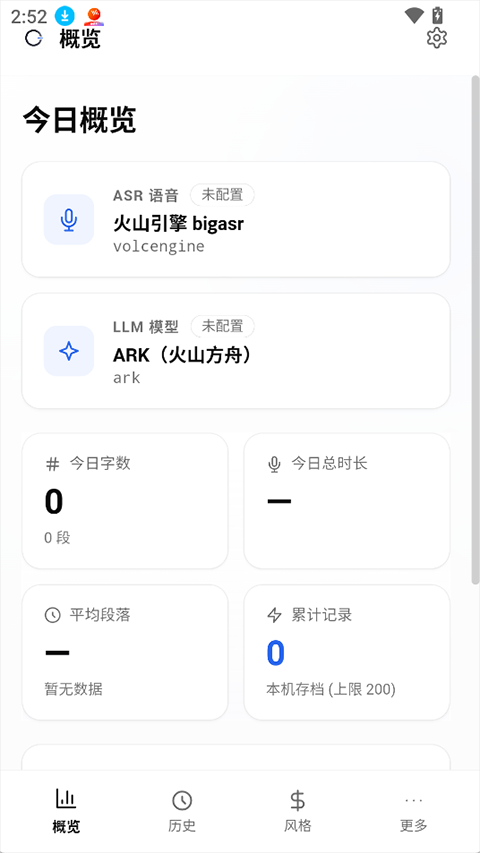
首次启动会弹一个引导窗口,让你选两件事:ASR 渠道和润色 LLM。ASR 是语音识别的引擎(火山引擎、讯飞、本地 Qwen3-ASR 都可选),润色 LLM 是把口语转成规整文字的大模型。这两步是整个链路的基础设施——选错了后面再改也能改,但跑起来体验差距很明显。建议第一次先用云 ASR 跑通全流程,再考虑要不要切本地 ASR。
权限方面,录音权限是必须的,另外 OpenLess 需要「悬浮窗」权限来显示状态胶囊——这是它做全局快捷键的关键。如果悬浮窗权限被系统回收(部分国产 ROM 会杀后台悬浮窗),快捷键会失效,重新打开就行。旧版本残留可能导致词典数据丢失——如果是从 1.2.x 升级上来的,建议进应用设置清一下缓存再开,避免热词优先级乱序。
热词预算:一个被忽视的资源约束
我第一次注意到 OpenLess 的词典热词机制,是因为发现一个反直觉的现象:我手动加了一堆专业术语到词典里,但用了几天之后,有些词条好像"不生效"了——ASR 还是把它们识别成同音字或模糊词。
翻文档才明白背后的根因:ASR 提供商给热词 hotwords 参数的字符预算是有限的,通常只有几百个字符。这个限制不是 OpenLess 自己定的,是云 ASR API 的设计——热词越长、越多,API 调用体积越大、延迟越高、成本越高。如果你的词典有 500 个词条,不可能全部塞进这几百字的热词参数里。
这是一个经典的资源受限场景:你有一个"想要全部命中"的全集,但通道容量远小于全集。大多数工具面对这个问题要么让用户手动选"哪些词条进热词"(麻烦),要么直接截断(随机丢词条)。OpenLess 的做法值得拆一下。
三层设计:优先级排序 + 双通路注入 + 润色兜底
OpenLess 的词典热词系统不是一个单一机制,是三层叠起来的。
第一层:动态优先级排序。每个词条有一个分数,由两个因素加权:累计命中次数(主权重)和手动添加标记(次权重)。每次你录音、ASR 识别某个词条命中了,这个词条的命中次数 +1,下次排序时就会往上爬。反过来,长期没被命中的词条自然下沉。
排序的具体规则是:热词预算前 5 个名额预留给最近手动添加但还没被命中过的词条——这是一个"新词条保护",确保你刚加的词立刻生效,不会被老词条挤掉。剩下的名额按命中次数从高到低填充。
这个设计的妙处在于:你不需要手动干预任何事。系统用"命中次数"这个最诚实的信号来决定谁进热词位——你真正常用的专业术语自然会爬到前面,偶尔用一次的词条沉下去也不亏。
第二层:双通路注入。热词预算限制只影响 ASR 识别环节。到了润色 LLM 这一步,词典的完整词条列表会作为 semantic hints 注入 prompt——润色模型不受几百字的字符预算限制,它能看到你全部 500 个词条。
这意味着:即使某个低频词条被挤出了 ASR 热词位,它仍然能在润色环节帮模型做同音字消歧。举个例子,ASR 可能把"正则表达式"识别成"正泽表达式"(同音字),但润色 LLM 的 semantic hints 里有完整的"正则表达式"词条,它会把它改回来。ASR 热词是"第一道保险",润色 hints 是"第二道兜底"。
第三层:Esc 作为全局取消。这和热词机制不直接相关,但它是整个状态机设计里和词典配套的关键一环——当你录音发现环境噪音太大、或者说到一半想改口,按 Esc 会立即丢弃当前会话的所有产物(录音文件、转写文本、润色结果),不执行任何插入。这个设计让你可以放心大胆地试词典效果,试坏了 Esc 重来,不会在光标位置插入垃圾文本。
取舍:这套设计的代价
这套机制听起来很完美,但有代价。
第一,润色质量依赖 LLM 能力。第二道兜底的效果完全取决于你选的润色模型。如果润色 LLM 太小、或者 semantic hints 的 prompt 模板写得差,低频词条还是会被漏掉。实测下来,用 DeepSeek 或火山方舟的大模型,润色环节的消歧命中率能到 90%+;但如果用本地小模型,可能只有 60% 左右。
第二,首次使用有一个"冷启动"窗口。新加的词条虽然有保留席位进热词位,但如果 ASR 本身对这个词的识别率就很低(比如很生僻的技术术语),你得在实际场景里用它几次,让命中次数累积起来,它才能稳定留在热词位。
第三,不支持手动干预优先级权重。目前 OpenLess 不让你手动给某个词条"加权"——如果你觉得某个词"应该高频但没爬上来",唯一的办法就是多录几次带这个词的内容。这是一个产品决策:自动规则驱动比手动调权重更不容易把系统搞乱,但确实少了一点灵活性。
判断:它适合谁
这套热词机制的设计思路,和 OpenLess 整体的产品定位是对齐的:给"真的在干活"的人用——程序员写技术文档、翻译写专业论文、运营写行业报告——这些人有大量专业术语需要准确识别,但又不想花时间手动配置热词列表。
如果你只是偶尔写几句日常消息,其实不需要关心词典机制——默认配置够用了。但如果你有明确的专业场景需要术语准确、又不想在热词配置上花太多时间,这套自动排序 + 双通路兜底的设计,是目前语音输入工具里我见过最务实的方案之一。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。