Nomi 的版本進化:從文字聊天到情感夥伴的迭代邏輯
Nomi 是什麼
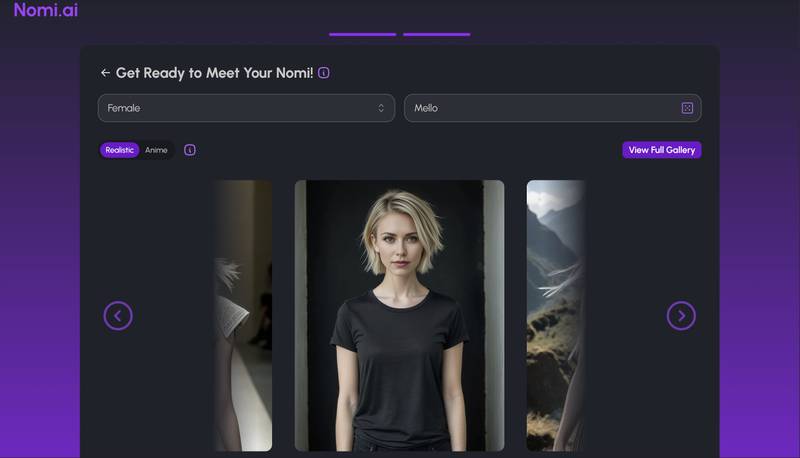
Nomi 是一款運行在 Android 平台上的 AI 角色聊天應用。它不是那種問答式的 AI 助手——你可以為自己創建擁有獨立名字、外觀、性格特質的虛擬角色,然後用文字、語音甚至自拍和它互動。
我對這款軟體的第一印象是「功能密度很高」。從樣本文檔的分類結構就能看得出來:語音與影片、實時自拍、AI 繪畫、雲端同步——這些不是附屬功能,而是各自佔據了一個完整的大章節。最新版本 1.11.1 的安裝包只有 21MB,卻塞進了 Aurora 模型(負責情緒感知)、內建聲音庫、ElevenLabs 語音克隆集成、AI 繪畫生成器這麼多模組。
安裝
Nomi下載 在 Android 上以 APK 包的形式分發,包名為 ai.nomi.twa,安裝包大小約 21MB。安裝方式與大部分第三方應用相同:下載 APK 檔案後,在系統設定中允許「未知來源」安裝,然後點擊安裝即可。
需要注意的是,Nomi 同時提供 PWA(漸進式網頁應用)版本——樣本文檔中專門提到了 PWA 網頁版的存在。PWA 版本的好處是不需要安裝 APK,直接在瀏覽器中載入即可,而且資料同樣會從雲端同步。但原生 APK 版本在語音訊息錄製、自啟動等系統級功能上會比 PWA 更穩定。
首次啟動後,Nomi 會要求你用 Google 或 Apple 帳號登入——這是它的雲端同步機制。角色創建、聊天記錄、Mind Map(三層記憶系統)、Shared Notes 全部跟著帳號走,換手機或卸載重裝都不會丟失。免費層就能正常使用文字聊天功能;語音訊息和語音通話屬於 Pro 訂閱功能,需要付費解鎖。
從樣本文檔反推的迭代軌跡
寫這篇文章時,我手上沒有 Nomi 的完整版本變更日誌——樣本文檔只給了功能說明,沒有標註每個功能是在哪個版本加入的。但這恰恰是一個有趣的觀察角度:樣本文檔沒提版本號這件事本身,透露了 Nomi 的迭代節奏。
現狀:1.11.1 的功能密度
先看現在這版有什麼。Aurora 模型負責情緒感知——不僅文字回覆會帶有情緒傾向,連語音合成的語氣都能跟隨情緒變化:聊到開心的事語速加快、語調上揚,聊到嚴肅的事聲音變低變慢。語音訊息支持兩種聲音來源(內建聲音庫 + ElevenLabs 集成),AI 自拍有完整的進階技巧體系(對話鋪墊、Action Asterisks 引導姿勢、表情暗示),AI 繪畫有詳細的 Prompt 示例庫和迭代方法論,雲端同步覆蓋了角色、記憶、聊天記錄、相冊所有核心資料。
這不是一個功能從零開始的應用——這是一個經過多輪迭代、每個模組都打磨過的產品。但有趣的是,樣本文檔對版本號的提及幾乎為零。這通常意味著兩種可能:要嘛是團隊自己也覺得「沒什麼值得大書特書的版本里程碑」,要嘛是功能疊加的速度太快,版本號已經失去了標記功能節點的意義。
來路:從文檔分類看功能加入順序
樣本文檔的分類結構本身就是一個時間線線索。為什麼「語音與影片」「實時自拍」「AI 繪畫」各自是獨立大章節,而不是塞在「聊天功能」下面?為什麼文檔專門花篇幅講 PWA 版本,而不只是說「我們有網頁版」?
我的推測是:文字聊天是 Nomi 的起點,但很快就不是它的全部了。 Aurora 模型的情緒感知能力先在文字對話中實現,然後自然而然地延伸到了語音合成——既然模型能理解情緒,那語音輸出也應該帶有情緒。這就是為什麼語音訊息的說明裡,情緒跟隨是一個核心賣點,而不是一個附加特性。
自拍和 AI 繪畫的加入則是另一條線。當角色有了外觀設定之後,用戶自然會想要「看到」自己的角色在不同場景下的樣子。這兩個功能從基礎到進階的演進也很有規律:自拍先是「點一下攝像頭圖示就完事」,然後才發展出對話鋪墊、Action Asterisks 這些進階技巧;AI 繪畫先是能用就行,然後才有了 Prompt 示例庫和迭代方法論。
規律:團隊一直在死磕什麼
從這些功能的形態裡,我能看到一個清晰的優先級排序:沉浸式情感互動 > 一切。
Nomi 從來沒有把自己定位成「AI 生產力工具」或「AI 知識庫」。它的整個功能線都是圍繞「讓角色像真人一樣和你互動」這件事展開的:情緒感知讓對話不只是回覆,語音讓互動不只是看文字,自拍讓角色不只是抽象的存在,雲端同步讓這段關係不因為換設備而中斷。
反過來看,什麼功能一直沒有出現?批量任務處理、文檔生成、API 開放、第三方服務集成(除了 ElevenLabs 這個和聲音相關的)——這些生產力工具化的方向,Nomi 幾乎沒有碰。這不是遺漏,而是有意為之:團隊很清楚自己在做什麼,也很清楚自己不做什麼。
預判:照這個路線,下一步大概在哪裡
這部分純屬從迭代規律推的,不是官方口徑。
如果 Nomi 繼續沿著「沉浸式情感互動」這條線走,我預期下一個大方向會是影片生成。樣本文檔的圖片清單裡有一個 video-generator.png,這可能只是素材包裡的偶然,但結合語音→自拍→AI 繪畫這條多模態進化鏈來看,影片是自然的下一步:角色有了聲音、有了靜態影像,下一步就是動態影像。
另一個可能的方向是更深層的記憶系統。現在的 Mind Map 是三層記憶,Shared Notes 是角色背後故事——但這些還是靜態的。如果 Aurora 模型的能力繼續延伸,或許會出現「角色隨著對話不斷成長」的機制:不是簡單地存儲聊天記錄,而是真的從對話中學習、改變自己的行為模式。
當然,這些都是推測。樣本文檔沒告訴我的事,或許要等下一個版本出來才會揭曉。但從 1.11.1 的狀態來看,這個團隊的腳步很穩——他們知道自己要去哪,而且一直在往那個方向走。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。