MultiTTS 离线多声部朗读的技术拆解
MultiTTS 是什么
你手机里的"文字转语音"功能,默认大多走 Google TTS。那个引擎的好处是开箱即用,坏处也很明显:网络依赖、音色有限、想换个喜欢的声音基本没门。MultiTTS官网 上提供了完整的替代方案——它把安卓原生的 TTS API 替换成自己的实现,让任何调用系统朗读的 APP 都能输出你指定的声音,而且全程离线。
说"简单粗暴"一点不夸张。同类 APP 很多要么只做"应用内朗读"(只能在自己的界面里用),要么还是走云端接口。MultiTTS 的思路是直接接管 Android 的 TextToSpeech 系统服务,变成一个真正的引擎——小说 APP、浏览器、PDF 阅读器、甚至视障用户的 TalkBack,只要调用系统 TTS,就会走到它的逻辑里。
安装
MultiTTS下载 拿到的是安卓 APK,当前版本 1.8.3,安装包约 145MB。安装过程和普通 APK 没区别,但它有两个其他 APP 不会让你做的事——设为系统默认 TTS,以及导入音源包。
APK 装上之后先别急着找"朗读"按钮。打开 APP 主界面,右上角菜单里找"设为默认 TTS",系统会跳到安卓的无障碍设置页面,在"首选引擎"下拉里选中 MultiTTS 就行。这一步是让安卓把所有 TTS 请求路由给它,不设默认的话,它就是个装在手机上的空壳,没人用。
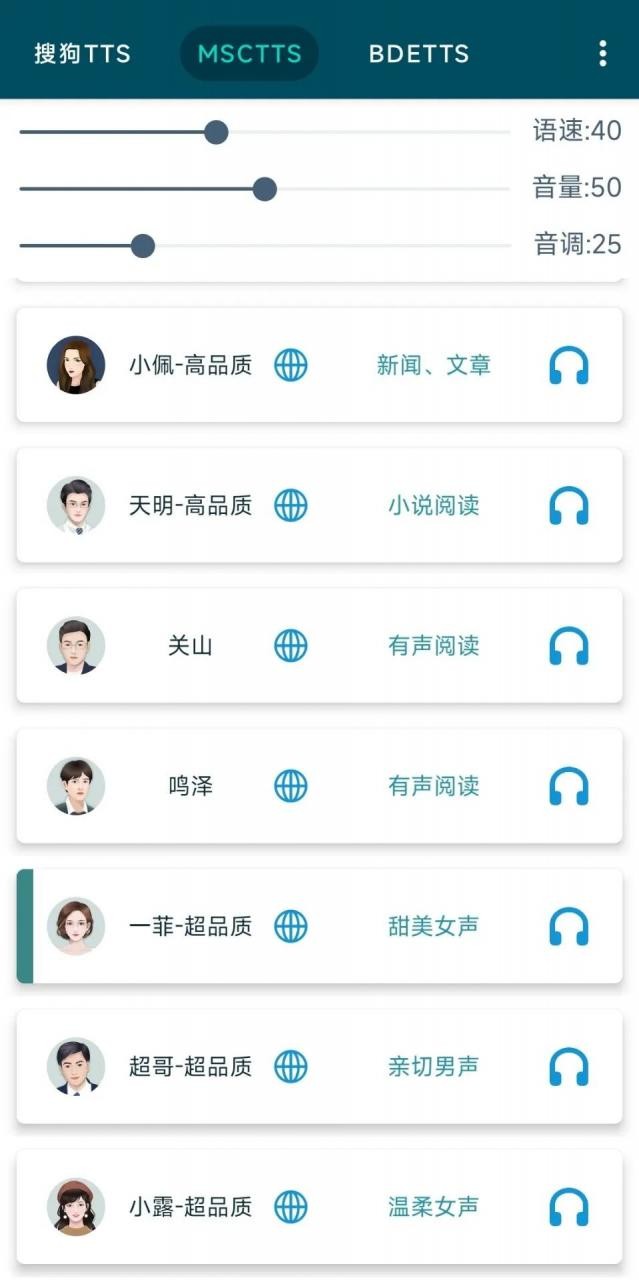
音源包是 MultiTTS 真正的"声音来源"。APK 本体不带任何语音数据,你得自己下载喜欢的音色包然后导入。导入入口在主界面发音人列表的添加按钮——选下载好的 zip 或目录,MultiTTS 会扫描里面的音频样本和配置文件,自动注册成可用发音人。音源包质量直接决定朗读效果,花点时间挑几个喜欢的音色比折腾配置重要得多。
另外注意一个坑:安卓的 TTS 服务进程偶尔会卡死,点了朗读没声音的时候,先回 MultiTTS 自己的小耳机图标试试能不能出声,能的话重启系统 TTS 服务(设置→应用→显示系统进程→文字转语音服务→强制停止),重启手机能解决八成以上的玄学问题。
它为什么能做离线 TTS:引擎架构拆解
现在聊正题。一个离线 TTS APP 说起来简单,但背后有几个硬骨头要啃:
第一,怎么让安卓系统认识你。 安卓的 TTS 体系是典型的"系统服务 + 引擎插件"模式——系统负责接收所有 APP 传来的朗读请求,然后分发给当前默认引擎。Google TTS、三星 TTS 这些都是引擎插件。MultiTTS 的工程核心就是实现了一套完整的引擎接口:它注册了一个 TTS Service,系统把文本和参数(语速、音调、发音人 ID)扔给它,它返回合成好的 PCM 音频流。
这个接口层的工作量不小,但真正有意思的是音源数据怎么组织。Google TTS 把模型编进 APK,每个引擎就那么几个固定声音。MultiTTS 不内置模型——它把发音人做成了可热插拔的数据包。每个发音人本质是一组语音样本加一个配置文件(记录采样率、声道、语速调整曲线等元数据)。导入音源包时,APP 扫描目录里的配置文件,把每个发音人的信息注册进自己的内部列表,同时在安卓 TTS 接口里上报可用发音人 ID。
第二,怎么处理"朗读"这件事本身。 这是个关键的设计取舍。完整的 TTS 流程包括文本分析(分词、标点处理)→ 韵律预测(哪里停、哪里升调)→ 声学合成(把文本变成声音波形)。Google TTS 走的是模型驱动路线,把这三步揉成一个神经网络。MultiTTS 走的是预录拼接路线——音源包里的每个发音人已经录好了大量音素和常用短语,APP 拿到文本后做分词,然后从样本库里拼接出对应的音频片段。
这个设计带来的影响分两面。好处是完全离线 + 极低延迟——不需要跑模型推理,查样本库比算神经网络快一到两个数量级。坏处是音色和表现力完全取决于音源包的录制质量——如果你导入的音源只有几百条短句样本,那长文本朗读时拼接痕迹会很明显,音素之间的过渡会不自然。
角色多声部:规则引擎能做什么、不能做什么
MultiTTS 最让用户惊喜的功能是"角色多声部朗读"——听小说时旁白用中性声、男主用磁性男声、女主用温柔女声,听感直接从"机器念"跃升到"多人演播"。这里的技术原理比你想象的简单,但也更有限。
它的核心是一个字符串包含匹配器加一个发音人路由表。用户在"角色管理"里配置规则,每条规则三要素:匹配模式(目前只支持"文本")、匹配条件(一段关键词或正则片段)、分配发音人(从已导入的发音人列表里选一个)。引擎拿到一段待朗读文本后,按规则列表从上到下依次做包含检测——文本里包含"男主"?那整条段落就用磁性男声。包含"【旁白】"?那用沉稳女声。
注意我说的是"整条段落"。MultiTTS 做的不是逐句甚至逐词的角色切换,而是按文本块匹配。你的小说 APP 导出的文本格式里,角色标记通常在段落开头("男主:……"),MultiTTS 检测到段落开头的标记,就把整个段落路由给对应的发音人。这意味着:
- 标记越规范,效果越好。正规阅读 APP 导出的文本通常有
角色名:对白格式,匹配器一把命中。 - 规则顺序很重要。具体规则放前面("张三""李四"),通用规则放后面(留空匹配所有文本),否则通用规则先抢走所有段落,角色规则永远触发不到。
- 它不是 AI。没有语义理解能力——文本里"他是一位男主"(不是对话标记)也会触发"男主"规则。匹配条件写得越精确越好。
这套设计的"能"和"不能"刚好形成对比。能的:只要文本格式对,规则写得好,听感接近专业有声书。不能的:文本没角色标记时无能为力(比如纯对白段落);同一个角色有多种写法("张三""三哥""张三少爷")需要多条规则覆盖;短对白片段切换发音人可能赶不上,偶尔会出现"角色话还没说完,发音人已经切走了"的情况。
为什么无声问题这么多:TTS 调用链的脆弱性
用过 MultiTTS 的人大概率遇过"点了朗读没声音"的情况。问题排查清单列了十步,从回 MultiTTS 自己试听到检查音频通道、重启 TTS 服务、卸载重装——这个长度本身就是一个技术信号。
安卓的 TTS 调用链是四级接力:APP → Android TTS API → 系统 TTS Service → MultiTTS 引擎。任何一级出问题都会导致无声。APP 端可能用了自己的 AI 朗读(微信读书就是),根本不走系统 TTS。系统 TTS Service 是一个常驻进程,安卓有时候会莫名其妙把它掐掉。MultiTTS 引擎可能因为音源包损坏导致发音人列表为空。最终音频还要走媒体音量通道——手机开了勿扰模式或者蓝牙路由到了空设备上也会静音。
MultiTTS 作为最末端的引擎,对前面三级几乎没有控制权。这就是为什么"回 MultiTTS 自己试听"永远是第一步——引擎自己能出声,说明引擎没问题,故障在调用链上游。引擎自己也不出声,那才需要检查音源包和安装状态。
这种架构脆弱性不是 MultiTTS 独有的——所有自定义 TTS 引擎都面临同样的问题。Google TTS 因为是系统内置组件,和系统 TTS Service 的绑定更紧,所以不容易出无声问题,但代价是你没法换掉它。
适用场景与边界
拆解完原理,结论很清晰:MultiTTS 的价值是用最朴素的工程手段绕过 Google 的服务锁定,让你对"谁来读你手机上的文字"这件事拥有完全的控制权。它不追求最先进的合成技术(预录拼接 vs 神经 TTS),它追求的是可替换、离线、可控。
适合的场景:喜欢听书且对默认引擎音色不满意的重度用户,想把自己收集的语音样本用起来的折腾党,视障用户想要 TalkBack 的多样化发音人。不太适合的场景:追求顶级合成质量(神经 TTS 的表现力远超预录拼接)、需要多语种混合朗读的用户。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。