brickit 如何让一堆散积木自己长出创意——拆解它的 AI 识别与推荐引擎
brickit 是什么
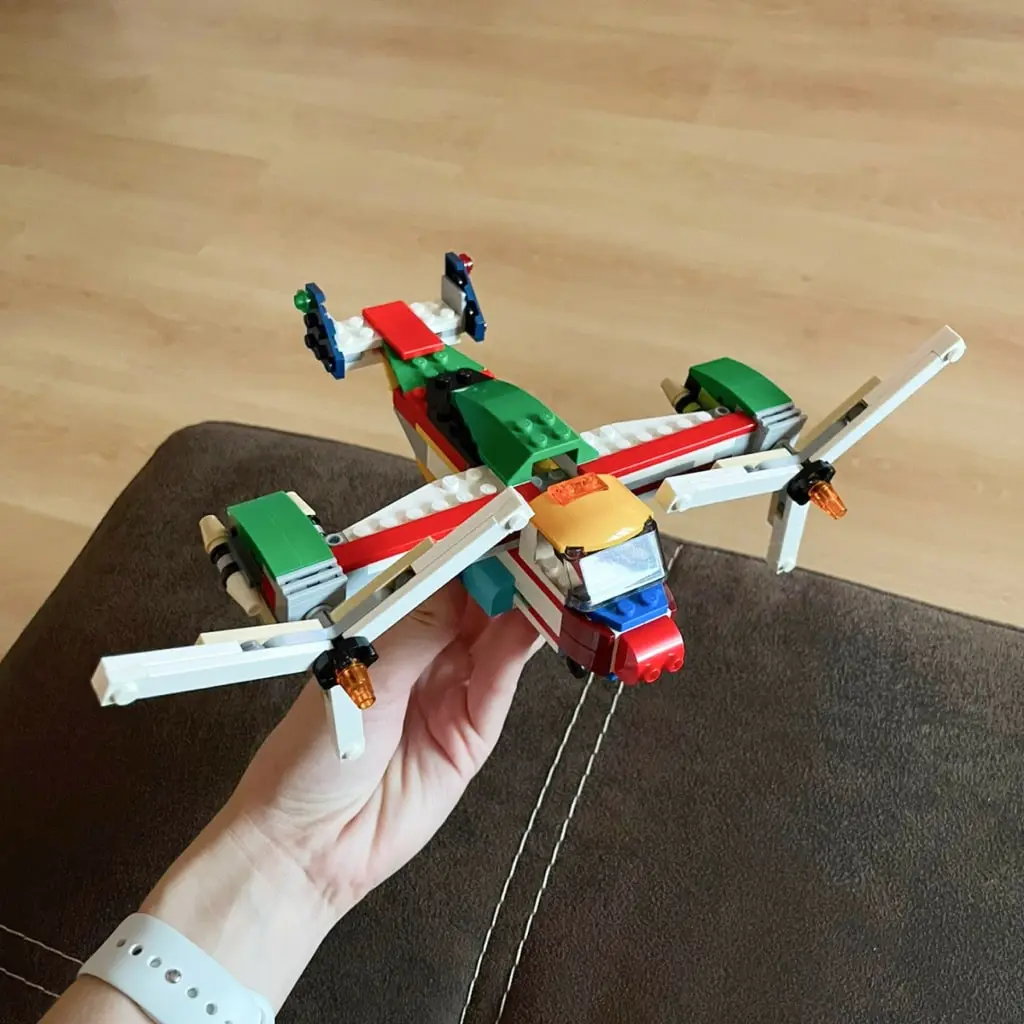
你面前有一筐乐高积木——可能是几年前孩子玩剩的,也可能是刚从二手市场淘来的。你想拼点什么,但翻着零件袋毫无头绪。brickit官网 上的定位很清楚:它就是为这个场景造的软件:打开手机,对着积木拍一张照,它会用 AI 把每一块零件的型号和颜色都识别出来,然后基于你手里现有的零件,从创意库里挑出几十到几百种你能搭的方案,每一种都附带分步搭建指南。
这听起来像是魔法,但拆开来看,brickit 做的事情其实可以归结为三个问题:你有什么零件? → 这些零件能拼什么? → 怎么一步步拼出来? 我感兴趣的不是它能干嘛,而是它为什么能做到——毕竟乐高积木形状这么多、颜色这么杂,AI 怎么保证识别得准?推荐引擎怎么在几万个创意里快速筛出你能搭的那几百个?这些设计背后有不少有意思的技术取舍。
安装
brickit 目前只做 Android 平台,安装包比较大——4.22.0 版本有 446MB,因为内置了完整的零件识别模型和创意库。安装方式就是标准的 APK 安装:从 brickit下载 获取最新版的 APK 文件,允许浏览器安装未知来源应用,然后点安装即可。
大文件安装有两个小提示:一是建议在 Wi-Fi 下下载,446MB 用移动数据不太划算;二是安装时如果弹出「应用未验证」的系统提示,这是安卓对非 Play Store 应用的常规警告,不是安全风险,选择「仍然安装」就能继续。
首次启动后 brickit 会请求相机权限(要用来拍积木)和存储权限(要保存扫描结果和搭建进度)。它不会强制注册登录,直接进入主界面就能开始扫积木。但如果你想同步库存数据或使用 Pro 功能,需要在设置里创建账号——免费版已经够用,Pro 版主要解锁完整创意库和批量修正工具。
为什么 AI 能认出乐高积木——标准化带来的红利
brickit 的第一个技术挑战是从一张照片里识别出每一块积木的型号和颜色。这件事放到通用物体识别里是地狱级难度——积木可能几百块堆在一起、互相遮挡、光线不均,换任何一个通用 CV 模型准确率都会很惨。
但 brickit 有一个所有通用模型都没有的底牌:乐高积木是高度标准化的工业产品。每一种型号都有精确的尺寸、固定的颜色编码,全球流通的几十年来规格从未变过。这意味着 brickit 的模型不需要在浩瀚的物体世界里搜索「这是什么」,它只需要在一个已知的、封闭的零件库里做匹配——候选集从百万级降到了数千级,识别难度直接差了几个数量级。
具体怎么做?从文档里提到的扫描特性来看,brickit 的识别链路大概是这样的:首先做图像分割,把照片里每一块积木的轮廓圈出来(这一步靠的是乐高积木之间的缝隙和高度差,在标准光照下不难做);然后对每个分割出来的区域做颜色归一化——不管照片偏黄还是偏蓝,都校准到标准色卡上;最后拿归一化后的区域去和零件库做特征匹配,找到最像的那个型号。
30 秒修正 vs 100% 准确——brickit 的容错哲学
但即使有标准化红利,brickit 也从不承诺 100% 准确率。文档里反复提到一个数字:「90% 准确率已经够用了」。这不是谦虚,而是一个有意识的设计取舍——把资源花在「让用户快速修正错误」上,而不是「让 AI 永不犯错」上。
这个取舍的底层逻辑很现实:追求最后那 10% 的准确率,训练成本和推理延迟可能要翻好几倍,而即便做到了,真实场景里还是会有积木叠在一起、光线极差、背景干扰这些无法控制的变量。不如换个思路:AI 做到 85-90% 准确,然后让剩下 10-15% 的修正变得足够快。
brickit 的修正工具就是为这个目标设计的——添加漏掉的零件、删除误认的、批量改同一类零件,每一步都控制在 30 秒以内。更聪明的是,修正之后推荐引擎会立刻基于新库存重算,你不用再等一轮扫描。这其实是一种「人机协同」的思路:AI 做大部分苦力,人负责快速收尾,两者配合比任何一方单独做到极致都更高效。
推荐引擎的核心——零件匹配不是搜索,是子集判断
扫描完、修正完,你有了一份零件清单。接下来 brickit 要回答第二个问题:这些零件能拼什么?
这里有一个容易被忽略的技术细节:推荐引擎做的不是「搜索关键词」,也不是「相似度匹配」——它做的是集合的子集判断。每个创意方案都有一份精确的零件需求清单:需要几块 2x4 的红色砖、几块 1x2 的蓝色板…… brickit 要做的,就是从几万个创意里找出「我的清单 ⊇ 创意清单」的那些方案。
这个判断如果朴素地做(对每个创意逐块比对),复杂度是 O(创意数 × 零件数),在手机上跑会很慢。brickit 能在几秒内出结果,大概率用了倒排索引——先把创意库按「需要某型号零件」建索引,比如「需要红色 2x4 的创意有哪些」,然后从你的零件清单出发做交集运算,候选集瞬间就能收敛到几千个以内。最后再对这几千个做精确的子集校验。
文档里提到的一个功能验证了这个推断:部分版本会显示「这个创意需要的 120 块零件你全有」或「缺 3 块」。这意味着推荐引擎不仅做了子集判断,还能输出差集——告诉你具体缺了什么零件。这个差集在后面的搭建过程中也有用:如果中途发现某步缺件,可以快速检查是不是库存里其实有替代品。
分步指南——怎么把创意拆成 200 个不卡壳的步骤
第三个问题最有意思:怎么把一个完整的创意,拆成几十到几百个「拿什么、拼在哪、怎么插」的小步骤,而且跳过任何一步都不会卡壳?
这本质上是一个结构拓扑排序的问题。乐高搭建有天然的层级:底座必须先于上层结构,支撑件必须先于被支撑件。如果拆步骤时没有遵循拓扑序,用户按指南搭到第 50 步时突然发现「哦,这块零件的插孔还没被底座盖住」——体验就崩了。
brickit 的做法应该是:先把创意方案建成一个零件连接图(graph),节点是每一块零件,边表示「A 必须在 B 之前安装」(比如 A 是 B 的底座)。然后对这个有向无环图做拓扑排序,得到一个合法的安装顺序。但光拓扑排序还不够——可能有好几个零件互相之间没有依赖关系,谁先谁后都行。brickit 这时候会用贪心算法:优先挑选「当前步骤涉及的零件在扫描图上的位置相邻」的那些,这样用户在按指南找零件时,不需要眼睛在屏幕上来回跳。
文档里提到的「高亮扫描图」功能也在这里:brickit 会把当前步骤需要的零件,在用户最开始拍的那张扫描照片上圈出来。这一步不需要重新识别——零件的坐标在第一次扫描时就已经存在了,只需要在渲染时把当前步骤涉及的那些高亮出来就行。这也是为什么推荐引擎需要精确的零件清单和位置数据——它贯穿了从扫描到搭建的整个链路。
这套原理的代价与边界
讲了这么多设计,这套原理也不是万能的,有几个明显的边界条件:
首先,积木必须是乐高(或和乐高 1:1 兼容的)。 brickit 的零件库是围绕乐高的标准型号建的,如果你用的是其他品牌的积木,识别准确率会断崖式下跌——这不是技术问题,是库的问题。
其次,零件量不能太小也不能太大。 文档里说「200 块以内分批扫」,再多 AI 的分割模型会开始混乱;而如果你的库存只有十几块零件,推荐引擎也给不出太多选择。
最后,通用 CV 模型 vs 专用库的路线选择。 brickit 走的是「封闭零件库 + 针对乐高优化的专用模型」路线,准确率和速度都不错,但扩展性差——换一种积木就得从头训练。如果哪天你想搭乐高以外的东西,它就无能为力了。
但这些边界其实都不是 brickit 需要解决的问题——它从一开始就只打算做好一件事:帮你把手里那堆乐高变成你能搭的东西。在这个目标下,它的每一个设计取舍都是对的:用标准化红利降低识别难度、用容错哲学替代完美准确率、用拓扑排序保证搭建不卡壳、用倒排索引加速推荐。把这些点串起来看,brickit 的技术链路其实很朴素——没有什么炫目的前沿算法,就是把几个经典问题的解法用对地方,再把它们打通成一条完整的流水线。
本文為個人基於網路公開資料整理編寫,非官方內容,僅供學習交流參考;軟體版權歸原作者所有,請支持正版;使用過程中遇到問題請查閱官方管道,本文不承擔任何責任。